完整指南:如何把 PDF 轉成 Markdown
為什麼有的 PDF 順順利利,有的非要 OCR 不可——以及兩種情況下怎麼拿到最乾淨的結果。
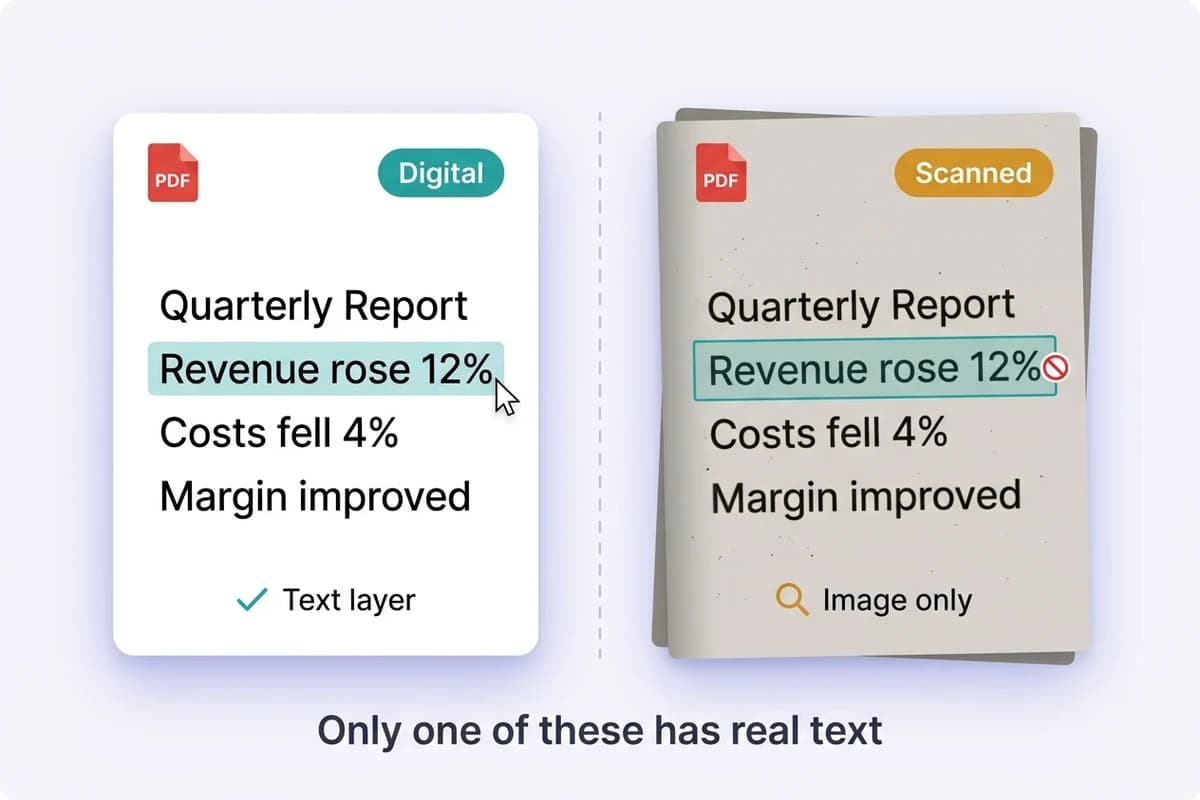
數位版 PDF 與掃描版 PDF
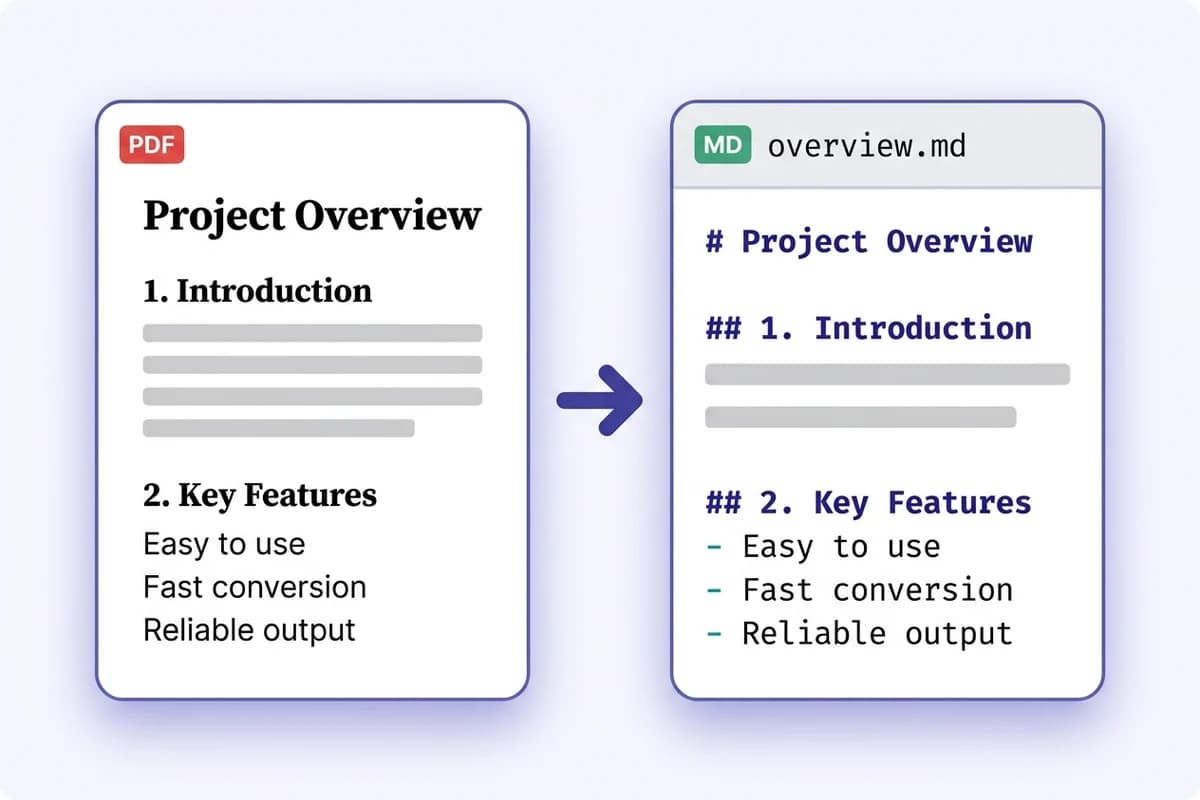
數位版 PDF —— 有文字層
由軟體產生(Word、LaTeX、瀏覽器的列印對話框)。字元確確實實在檔案裡,所以擷取又快又幾乎不掉東西。日常文件裡大約 97% 屬於這一類,幾秒就結束。
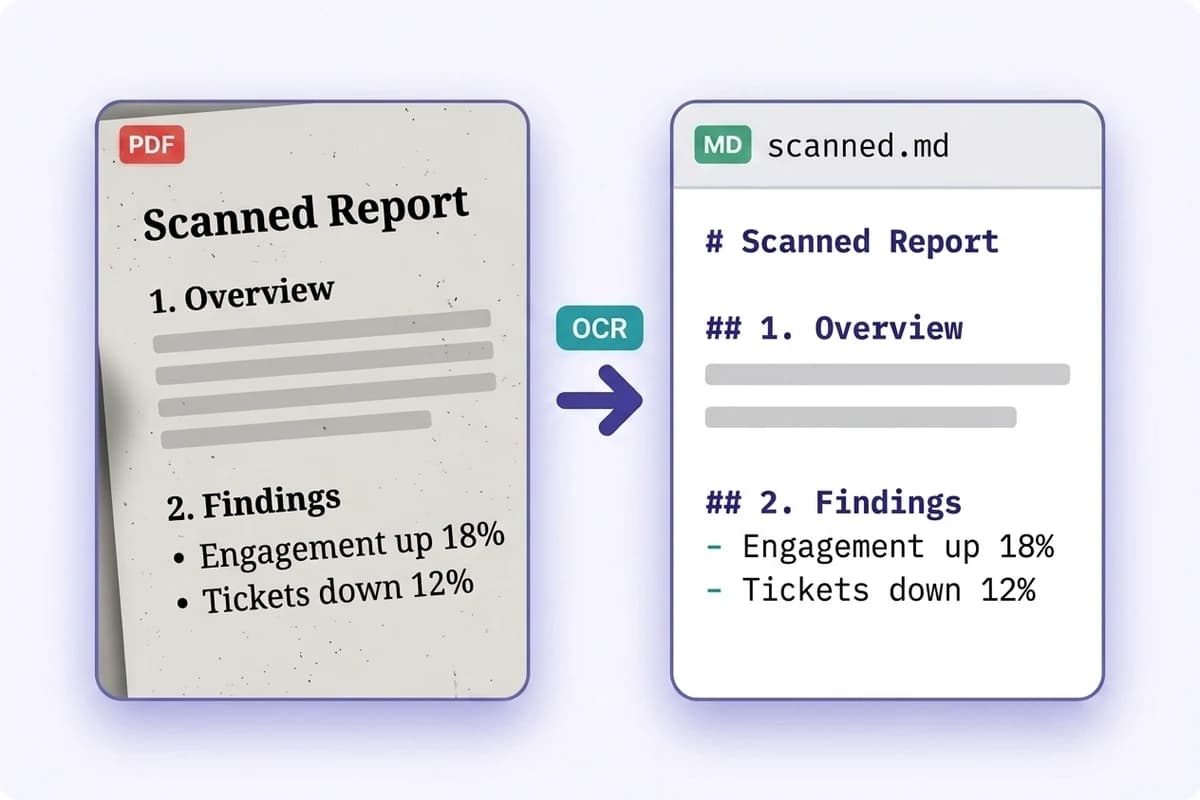
掃描版 PDF —— 只是一頁頁照片
從影印機、手機相機或傳真機出來的。沒有文字可擷取,選取複製什麼也拿不到。只有 OCR 讀得動——這正是多數免費工具默默還你一個空檔案的原因。
哪些轉得好
單欄文件
報告、技術文件、論文、合約都轉得乾淨:標題保住層級,清單保住巢狀。
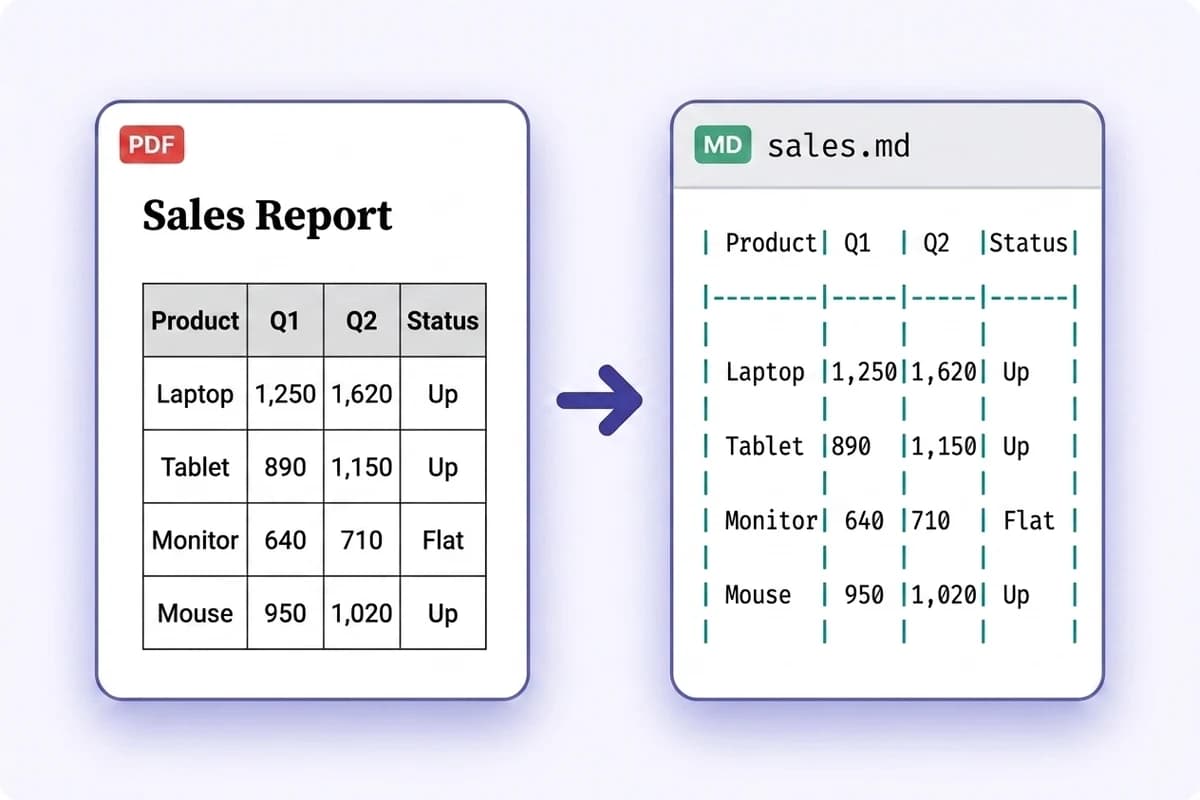
有框線的表格
框線看得見的表格會重建成 Markdown 表格,在哪裡打開都顯示正常。
內嵌圖片
PDF 裡的圖會被抽出來並在內文中引用,文件不會缺東西。
掃描檔與表單
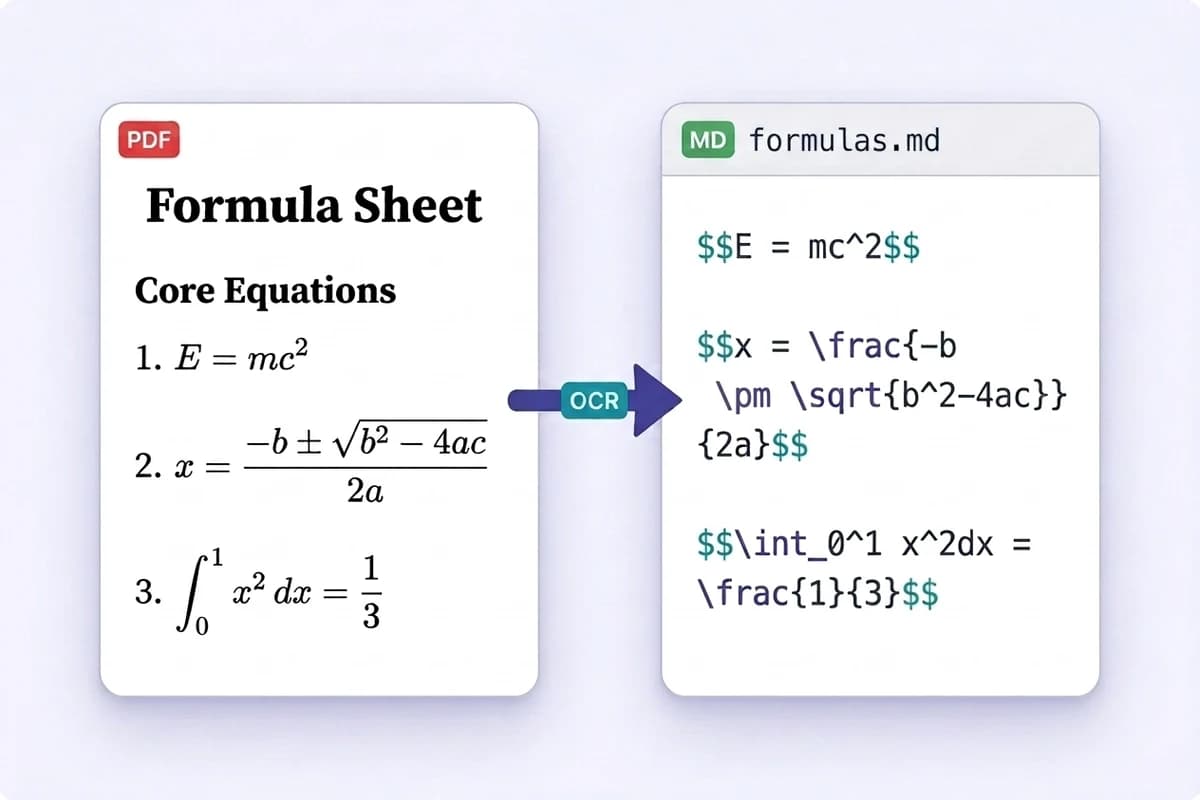
沒有文字層的頁面由 OCR 辨識,多語言排版和填好的表單同樣能處理。
怎樣才能轉得最乾淨
- 1.
先讓自動判定拿主意
原樣上傳就行。工具會先看有沒有文字層,只有檔案確實需要時才提示 OCR,不會讓你為用不上的 OCR 付費。
- 2.
出亂碼時手動強制走 OCR
舊掃描檔有時帶著多年前留下的劣質 OCR 文字層。這種情況騙得過任何自動判定,所以結果頁一直留著「改用 OCR 重試」按鈕——文字出來是亂的,就按它。
- 3.
多欄頁面記得複查
側邊欄、註腳、雙欄論文是按 PDF 內部儲存順序讀的,而那個順序不一定等於人的閱讀順序。這些地方在採信之前先掃一眼。
- 4.
太長的文件拆開轉
頁數上限之所以存在,是因為耗時隨篇幅增加。書籍或卷宗建議按章節轉——順帶也更好逐段複查。