무료 — OCR 포함

PDF Markdown 변환 — 무료, 스캔본까지

스캔된 PDF 앞에서는 대부분의 변환기가 손을 듭니다. 이 도구는 그것을 알아보고 OCR을 돌려, 보고서와 계약서와 신청서를 표·제목·수식이 살아 있는 진짜 Markdown으로 만들어 줍니다.

여기에 PDF를 끌어다 놓거나 눌러서 고르세요

10 MB, 30쪽까지 · 로그인하면 한도가 올라갑니다

PDF를 Markdown으로 변환한다는 것

PDF를 Markdown으로 변환하는 일은 PDF 안에 갇힌 글과 구조를 꺼내 일반 텍스트로 다시 쓰는 작업입니다. 제목은 우물 정 기호 줄이 되고, 표는 세로줄 표가 되며, 이미지도 함께 따라옵니다. 까다로운 지점은 따로 있습니다. 세상 PDF의 상당수는 텍스트 층이 아예 없는 스캔본이라, 추출해도 아무것도 나오지 않고 OCR만이 답이 됩니다. 이 도구는 어느 쪽인지 스스로 판별합니다. Markdown이 손에 들어오면 Word (.docx), PDF, HTML로 이어 갈 수 있습니다.

PDF에서 Markdown으로 가는 세 가지 길

1

온라인 변환기 — PDF를 올리면 몇 초 만에 Markdown이 돌아옵니다. 아무것도 설치하지 않고 구조를 지키고 싶을 때 가장 좋은 선택이며, OCR이 필요한 스캔본에는 사실상 유일한 길입니다.

2

명령줄 도구pymupdf4llm이나 marker 같은 라이브러리는 로컬에서 돌고 일괄 처리 스크립트도 짤 수 있습니다. 파일이 많은 개발자에게 맞지만 설치와 조정이 필요하고 OCR은 기본으로 딸려 오지 않습니다.

3

복사해서 붙여넣기 — PDF 뷰어에서 글을 긁어 편집기에 붙이는 방법. 한 문단이라면 충분하지만 제목과 표, 여러 단 편집은 무너지고, 스캔한 쪽에서는 아무것도 나오지 않습니다.

Example Output

결과물이 실제로 어떻게 나오는지

복사해서 붙여넣기로는 결코 안 되는, 이 변환기가 제대로 해내는 네 가지.

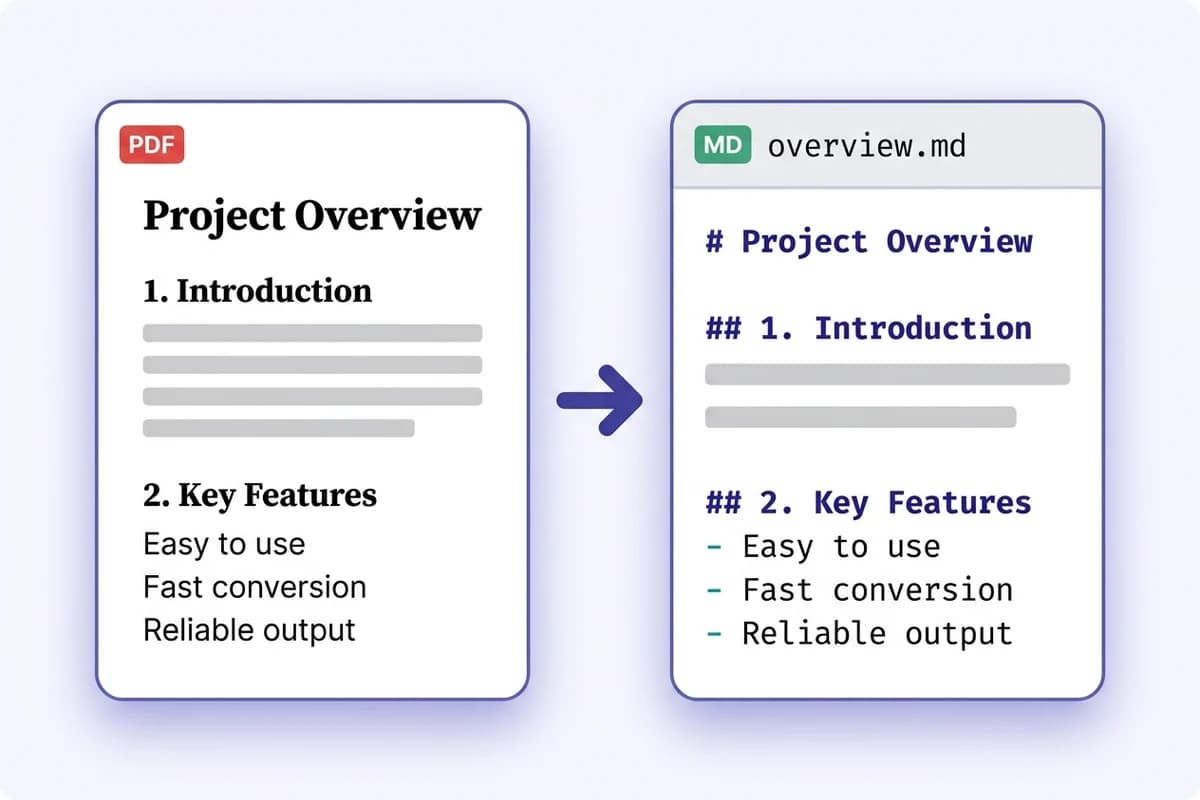
제목과 구조가 살아남습니다

제목 단계, 중첩 목록, 문단 구분이 진짜 Markdown으로 다시 세워지므로, 문서는 밋밋한 글 덩어리가 아니라 바로 고치거나 올릴 수 있는 상태가 됩니다.

PDF 프로젝트 개요를 제목 단계와 중첩 목록을 그대로 살려 구조화된 Markdown으로 변환한 예

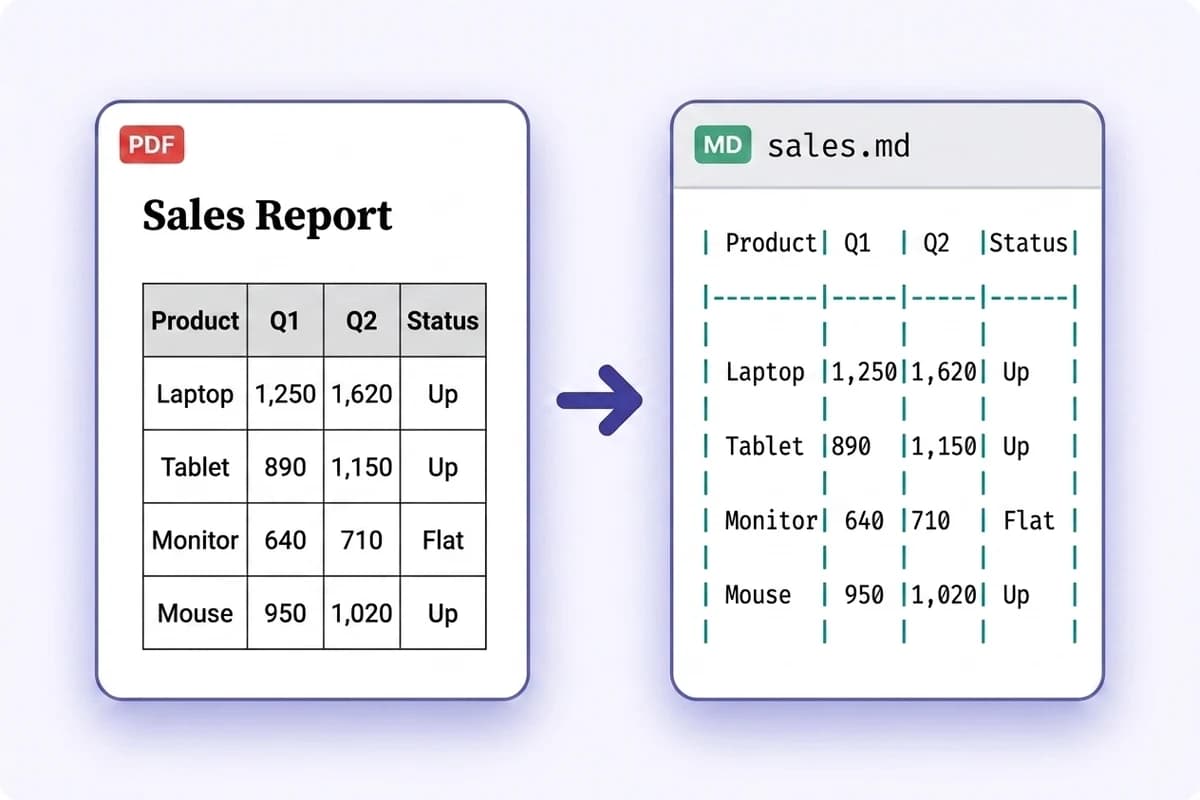
표가 Markdown 표로 바뀝니다

테두리가 있는 표는 열이 가지런한 세로줄 표로 다시 만들어집니다. 보고서·사양서·비교표가 흩어진 글이 되지 않고 그대로 다시 쓸 수 있습니다.

PDF의 매출 표를 열이 가지런한 Markdown 표로 변환한 예

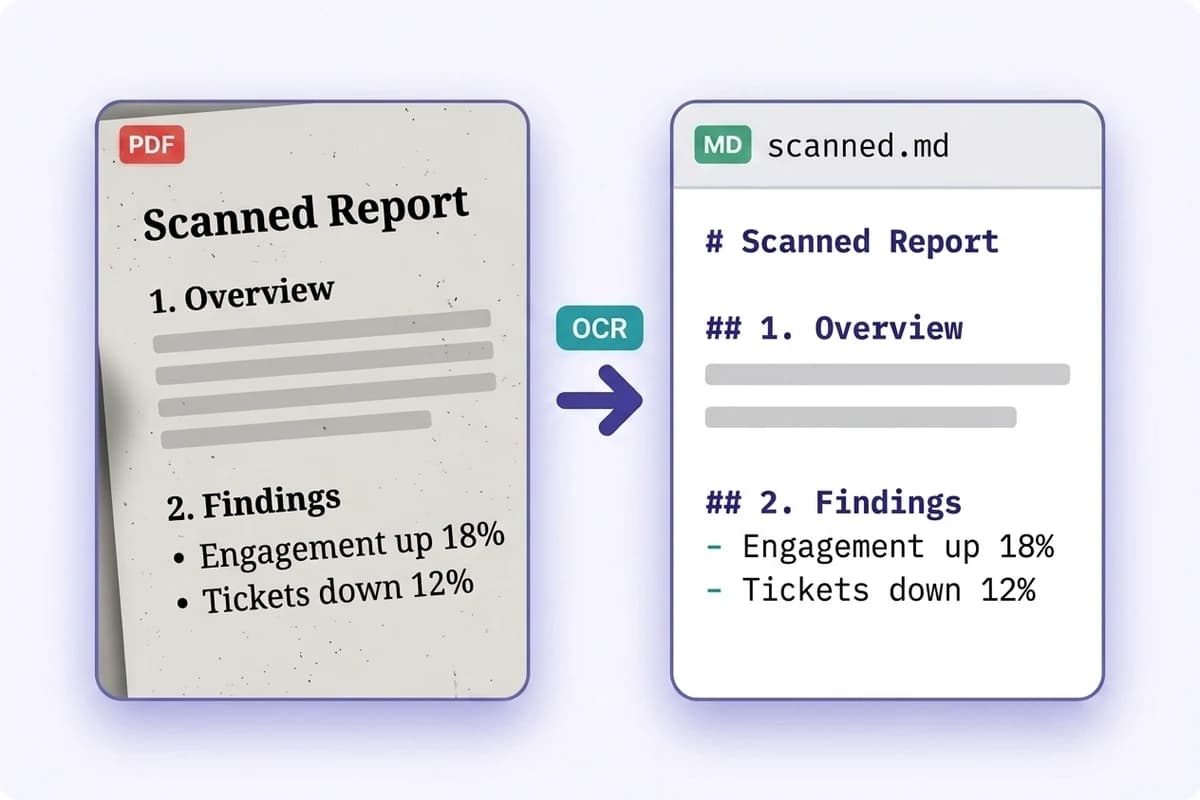
스캔한 쪽은 OCR이 읽습니다

PDF에 텍스트 층이 없으면 대신 쪽 이미지를 OCR로 읽습니다. 스캔본, 사진으로 찍은 문서, 신청서까지 170개가 넘는 언어를 다루며 중국어·일본어·한국어도 포함합니다.

스캔한 종이 보고서를 OCR로 인식해 편집할 수 있는 Markdown으로 바꾼 예

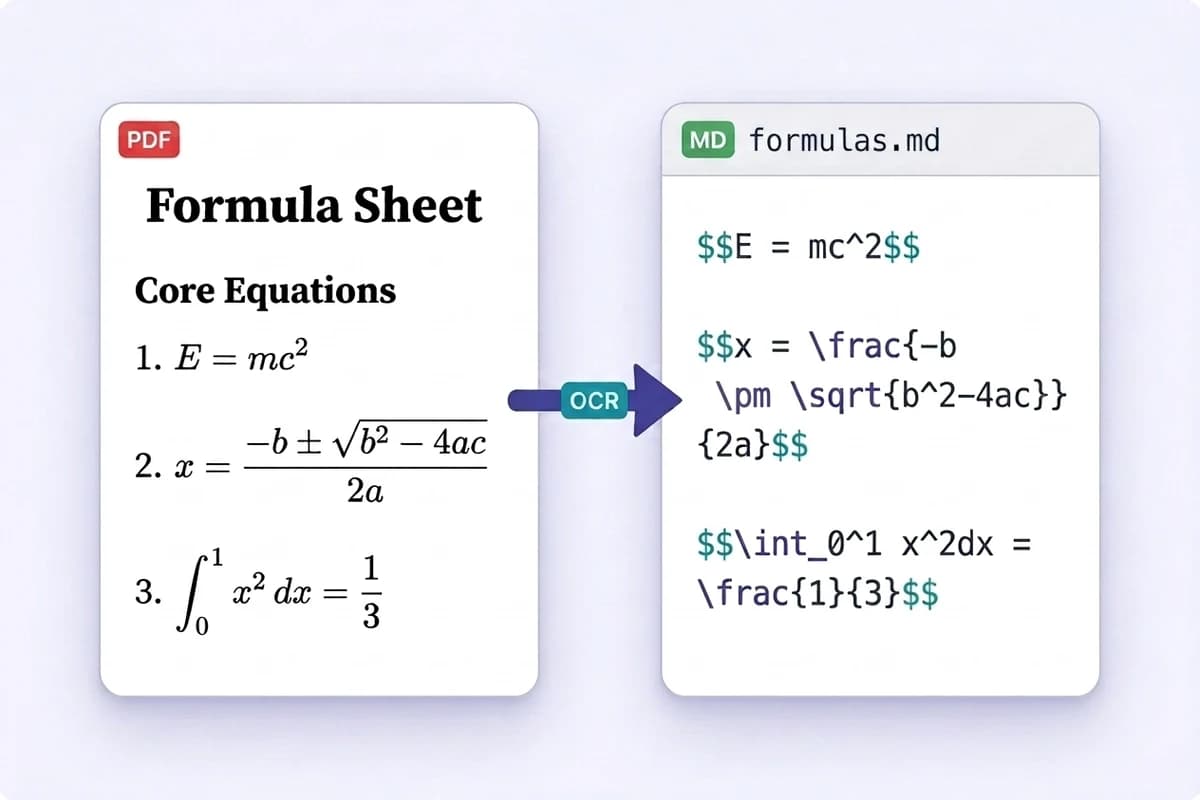
수식은 LaTeX로 돌아옵니다

수식 모음을 OCR에 넣으면 수학이 $$ 블록 안에 진짜 LaTeX로 돌아옵니다. 분수·근호·적분·위첨자가 구조를 지킨 채로 나와 Obsidian이나 Notion, 논문에 바로 붙일 수 있습니다. (디지털 PDF는 수식을 흩어진 글자 모양으로 저장하기 때문에, 제대로 되살리는 길은 OCR입니다.)

PDF 수식 모음을 OCR로 변환해 달러 기호 블록 안에 LaTeX 수식이 담긴 Markdown으로 만든 예

완전 안내: PDF를 Markdown으로 변환하기

어떤 PDF는 매끄럽게 지나가고 어떤 PDF는 OCR이 필요한 이유, 그리고 두 경우 모두 가장 깨끗한 결과를 얻는 방법.

디지털 PDF와 스캔 PDF

디지털 PDF — 텍스트 층이 있음

소프트웨어가 만든 파일입니다(Word, LaTeX, 브라우저 인쇄 창). 글자가 실제로 파일 안에 있어 추출이 빠르고 손실도 거의 없습니다. 일상 문서의 약 97 %가 여기에 해당하며 몇 초면 끝납니다.

스캔 PDF — 쪽을 찍은 사진일 뿐

복사기, 휴대폰 카메라, 팩스에서 나온 파일입니다. 뽑아낼 글자가 없어 긁어서 복사해도 아무것도 잡히지 않습니다. 읽어 낼 수 있는 것은 OCR뿐이고, 그래서 대부분의 무료 변환기가 조용히 빈 파일을 돌려줍니다.
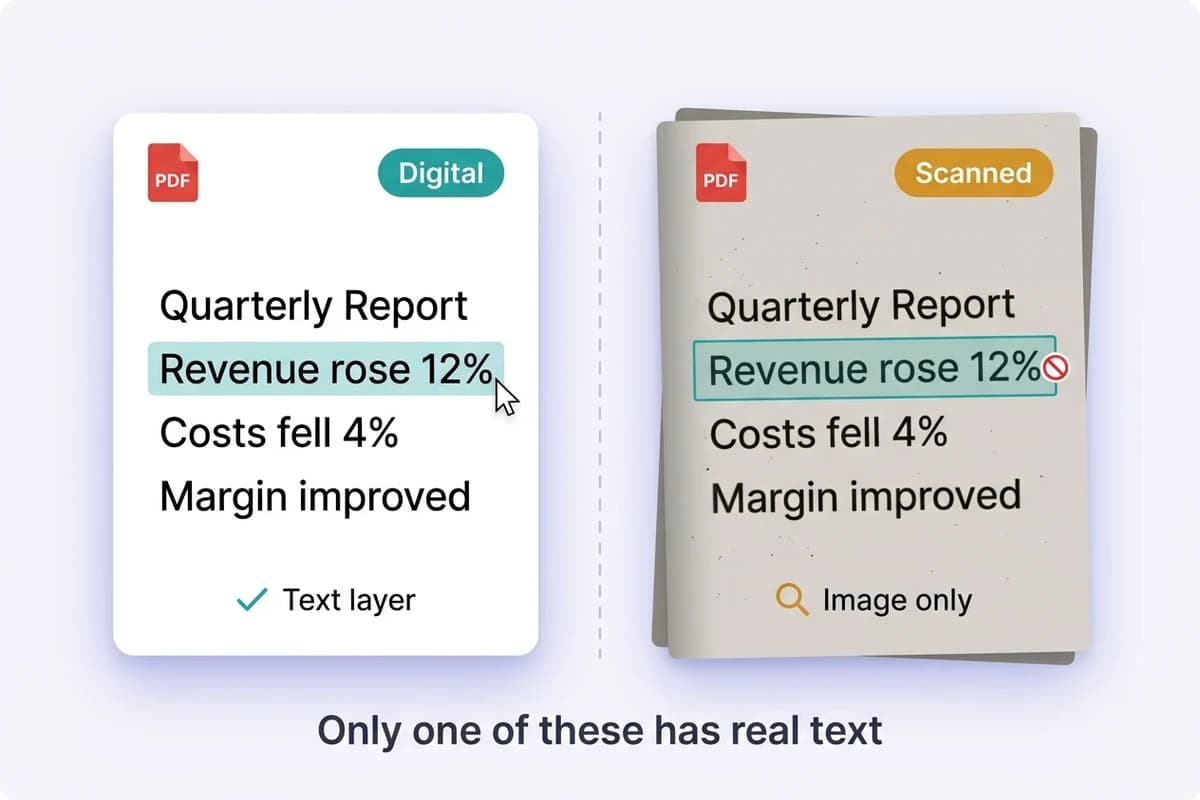
디지털 PDF와 스캔 PDF를 나란히 놓고 어느 쪽에 OCR이 필요한지 보여 주는 그림

잘 변환되는 것

한 단으로 된 문서

보고서, 기술 문서, 논문, 계약서는 깔끔하게 지나갑니다. 제목은 단계를 지키고 목록은 중첩된 채 남습니다.

테두리가 있는 표

선이 보이는 표는 Markdown 표로 다시 만들어져 어디서 열어도 제대로 보입니다.

문서에 박힌 이미지

PDF 안의 그림은 뽑아내 본문에서 참조하므로 문서에서 빠지는 것이 없습니다.

스캔본과 신청서

텍스트 층이 없는 쪽은 OCR이 인식합니다. 여러 언어가 섞인 편집이나 작성이 끝난 서식도 다룹니다.

가장 깨끗한 결과를 얻으려면

  1. 1.

    먼저 판별에 맡기세요

    그냥 그대로 올리면 됩니다. 도구가 텍스트 층이 있는지 살펴보고 정말 필요할 때만 OCR을 제안하므로, 쓸데없는 OCR에 값을 치를 일이 없습니다.

  2. 2.

    글자가 깨져 나오면 OCR을 직접 돌리세요

    오래된 스캔본은 여러 해 전의 엉성한 OCR 층을 달고 있는 경우가 있습니다. 여기에는 어떤 판별도 속아 넘어가므로 결과 화면에 '대신 OCR 실행' 단추를 남겨 두었습니다. 글자가 뭉개져 나올 때 쓰면 됩니다.

  3. 3.

    여러 단으로 된 쪽은 다시 읽어 보세요

    옆단, 각주, 두 단짜리 논문은 PDF가 저장한 순서대로 읽히는데 그 순서가 사람이 읽는 순서와 늘 같지는 않습니다. 그대로 믿기 전에 그 부분만 훑어보세요.

  4. 4.

    아주 긴 문서는 나누세요

    쪽수 제한이 있는 이유는 길이에 따라 시간이 늘기 때문입니다. 책이나 사건 기록은 장 단위로 변환하는 편이 좋고, 검토하기도 훨씬 수월합니다.

Key Capabilities

이 PDF Markdown 변환기가 다루는 것

읽고 마는 문서가 아니라, 계속 손볼 문서를 위해 만들었습니다.

스캔 PDF를 위한 OCR

텍스트 층이 없는 쪽은 이미지에서 인식합니다. 스캔본, 사진, 신청서까지 170개가 넘는 언어를 다루며 중국어·일본어·한국어도 포함합니다.

구조를 그대로 유지

제목 단계, 중첩 목록, 인용이 진짜 Markdown으로 돌아옵니다. 문단이 납작하게 눌린 덩어리가 되지 않습니다.

세로줄 표로 정리

테두리가 있는 표는 열을 맞춰 다시 만들어져 어떤 Markdown 편집기·위키·저장소에서도 제대로 보입니다.

수식과 이미지

박혀 있던 그림은 문서와 함께 따라오고, 스캔된 기술 문서의 수학 표기는 OCR이 되살려 냅니다.

다시 Word로

Markdown을 한 번의 클릭으로 Word 변환기에 넘겨 .docx를 내려받으세요. PDF가 주지 않던, 고칠 수 있는 문서가 여기서 생깁니다.

변환 뒤 삭제

파일은 암호화된 연결로 전송되어 이번 변환에만 쓰이고 그 뒤 삭제됩니다. 보관하지도, 분석하지도 않습니다.

Use Cases

PDF Markdown 변환은 누가 쓰나

이 도구가 날마다 해내는 다섯 가지 일. 하나쯤은 당신 이야기일 겁니다.

개발자

API 문서, 사양서, 공급사 매뉴얼을 PDF에서 꺼내 문서 사이트나 README, 위키로 옮기세요. 버전 관리에 그대로 들어가는 Markdown입니다.

연구자

논문을 Obsidian·Notion·Zotero용 Markdown 노트로 바꾸세요. 스캔된 과월호는 OCR을 거치고, 수식은 깨진 글자가 아니라 LaTeX로 돌아옵니다.

집필과 편집

고객 보고서, 브리프, 보도자료 묶음에서 깨끗하고 고칠 수 있는 글을 한 쪽도 다시 치지 않고 얻은 뒤, 늘 쓰던 Markdown 편집기에서 이어 가세요.

학생

강의 슬라이드, 유인물, 사진으로 찍은 필기를 Markdown으로 바꾸면 시험 전에 검색하고 요약하고 다시 배열할 수 있습니다. 사진으로 찍은 쪽은 OCR이 맡습니다.

AI·RAG 파이프라인

언어 모델이 가장 잘 읽는 형식이 Markdown입니다. 지식 베이스나 미세조정 데이터, 프롬프트에 넣기 전에 원본 PDF를 변환해 두면 구조는 살아 있고 PDF 특유의 잡음은 사라집니다.

Simple Process

PDF를 Markdown으로 변환하는 방법

세 단계면 되고, 시작하는 데 계정은 필요 없습니다.

01

PDF 올리기

파일을 끌어다 놓거나 찾아서 고르세요. 용량과 쪽수는 처리 전에 확인하므로 어차피 거절될 파일을 기다릴 일이 없습니다.

02

디지털인지 스캔인지 알아서 판별

텍스트 층이 있는 문서는 바로 변환됩니다. 스캔본으로 밝혀지면 OCR을 돌리기 전에 물어봅니다. 말없이 차감하는 일은 없습니다.

03

Markdown 복사하거나 내려받기

결과를 살펴본 뒤 클립보드로 복사하거나 .md 파일을 내려받으세요. 스캔본이 깨져 나왔다면 단추 하나로 OCR을 다시 돌릴 수 있습니다.

FAQ

PDF Markdown 변환 자주 묻는 질문

한도, OCR, 품질, 개인정보를 에두르지 않고 답합니다.

1

이 PDF Markdown 변환기는 무료인가요?

네. 누구나 날마다 무료 변환 횟수가 있고, 계정을 만들면 용량과 쪽수 한도가 올라갑니다. 스캔 파일 OCR은 변환 한 번에 크레딧 하나를 씁니다. 뒤에 유료 인식 엔진이 돌기 때문입니다.

2

스캔된 PDF에서도 되나요?

됩니다. 그리고 그 점이 대부분의 무료 변환기와 갈리는 지점입니다. 도구가 PDF에 진짜 텍스트 층이 있는지 확인하고, 없으면 OCR을 제안해 쪽 이미지에서 글자를 읽어 냅니다.

3

용량과 쪽수 한도는 어떻게 되나요?

계정 없이 10 MB, 30쪽까지 변환할 수 있습니다. 로그인하면 30 MB, 150쪽으로 올라가고 스캔 파일의 OCR이 열리며, 구독자는 50 MB, 300쪽까지 가능합니다.

4

OCR은 어떤 언어를 인식하나요?

170개가 넘습니다. 중국어·일본어·한국어·아랍어와 주요 유럽 언어가 들어갑니다. 여러 언어가 섞인 쪽도 한 번에 처리하므로 미리 언어를 고를 필요가 없습니다.

5

표는 그대로 남나요?

테두리가 있는 표는 Markdown 표로 안정적으로 바뀝니다. 선이 없는 표와 셀을 많이 합친 표는 어떤 PDF 분석기에도 약한 부분이니, 믿고 쓰기 전에 그 대목은 확인하세요.

6

PDF 안의 이미지는 어떻게 되나요?

박혀 있던 이미지는 뽑아내 Markdown에서 참조하므로 문서와 함께 움직입니다. 이미지가 아주 많은 큰 PDF는 파일을 다룰 만한 크기로 유지하기 위해 이미지가 빠질 수 있고, 그럴 때는 알려 드립니다.

7

수식도 지원하나요?

스캔 문서에서는 OCR이 수식을 LaTeX 표기로 되살립니다. 디지털 PDF는 수식 구조를 표시 언어가 아니라 배치된 글자 모양으로 저장하므로 복잡한 식은 그냥 글자로 넘어옵니다. 그런 쪽은 OCR을 돌리는 편이 결과가 나은 경우가 많습니다.

8

결과가 뒤죽박죽인 이유는 뭔가요?

여러 단 편집, 옆단, 각주는 PDF가 저장한 순서대로 읽히는데 그 순서가 사람이 읽는 순서와 늘 맞지는 않습니다. 한 단짜리 문서가 훨씬 깨끗하게 나옵니다. 글자 자체가 뭉개져 있다면 파일이 엉성한 OCR 층을 달고 있을 가능성이 큽니다. 결과 화면에서 '대신 OCR 실행'을 눌러 보세요.

9

제 PDF는 안전한가요?

안전합니다. 파일은 암호화된 연결로 전송되고 요청하신 변환에만 쓰이며, 처리가 끝나는 즉시 저장소에서 지워집니다. 문서를 읽지 않고, 모델 학습에 쓰지 않으며, 팔거나 공개하지도 않습니다. 업로드된 파일을 어떻게 다루는지는 개인정보처리방침에 자세히 적어 두었습니다.

10

PDF 변환에 크레딧이 드나요?

로그인 후에는 모든 변환에 크레딧을 사용합니다. 30쪽마다 1크레딧이며, 남는 쪽수는 올림하여 1크레딧으로 계산하고, 스캔 파일 OCR도 같은 규칙입니다. 구독자는 제한이 없습니다.

그 PDF를 고칠 수 있는 문서로

스캔본이든 디지털이든 먼저 Markdown으로, 그다음 Word·PDF·HTML로.

바로 시작 · 매일 무료 변환 · 스캔 PDF는 OCR로 지원