免费 — 含 OCR

免费 PDF 转 Markdown — 扫描版也能识别

遇到扫描版 PDF,多数转换工具直接歇菜。这个会先认出来再走 OCR,扫描的报告、合同、表单照样能出成真正的 Markdown,表格、标题、公式都在。

把 PDF 拖到这里,或点击选择

最大 10 MB、30 页 · 登录可提高上限

PDF 转 Markdown 到底在做什么

PDF 转 Markdown,就是把锁在 PDF 里的文字和结构取出来,重新写成纯文本:标题变成井号开头的行,表格变成竖线表格,图片跟着一起走。真正麻烦的地方在于,相当一部分 PDF 其实是压根没有文字层的扫描版——直接提取什么都拿不到,只有 OCR 能救。本工具会自己判断你手上是哪一种。拿到 Markdown 之后,还能继续转成 Word(.docx)PDFHTML

从 PDF 到 Markdown 的三条路

1

在线工具——传个 PDF,几秒钟就拿到 Markdown。想保住结构又不愿装东西时最合适,而对需要 OCR 的扫描件来说,这基本是唯一可行的路。

2

命令行——pymupdf4llmmarker 这类库在本地跑,能写脚本批处理。适合要处理大量文件的开发者,代价是得装环境、调参数,而且默认不带 OCR。

3

复制粘贴——在 PDF 阅读器里选中文字再粘到编辑器。就一段的话够用,但标题、表格和多栏排版会散架,扫描页更是一个字都拿不到。

Example Output

转出来到底长什么样

复制粘贴永远做不到的四件事,这个工具做对了。

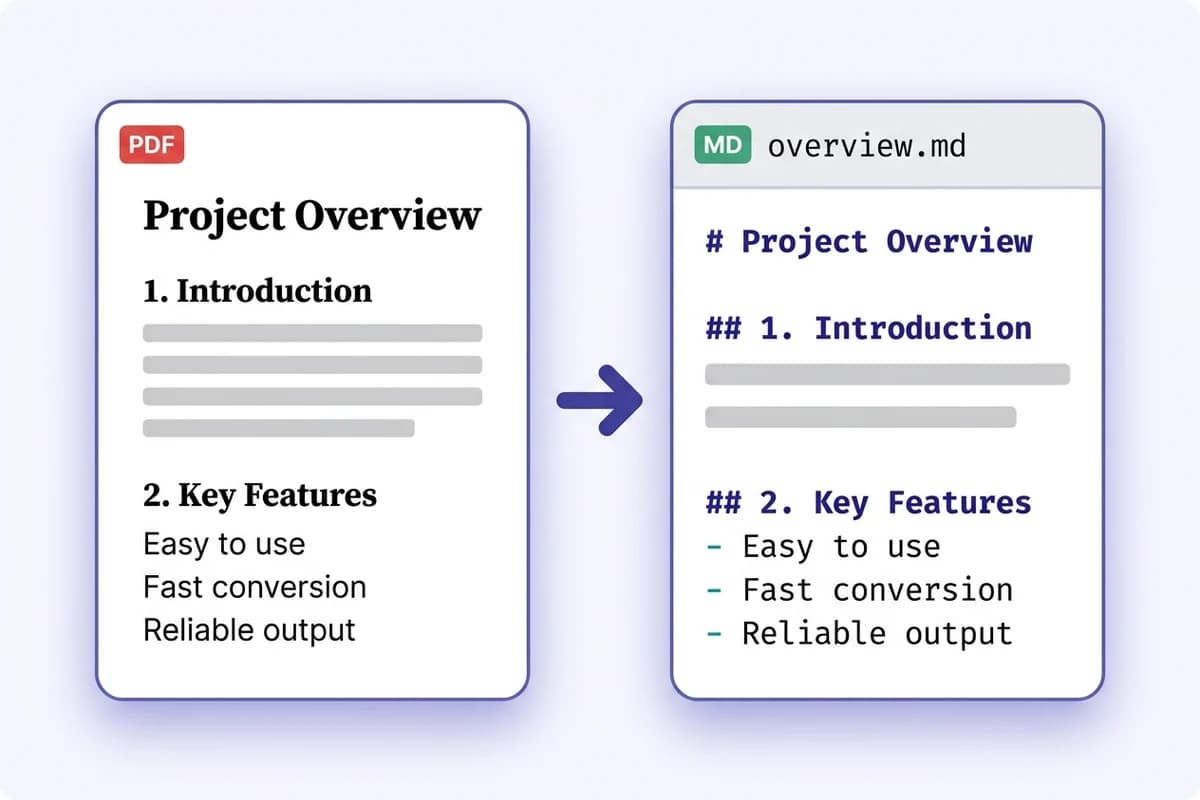
标题和结构都留得住

标题层级、嵌套列表、段落分隔会被重建成真正的 Markdown,文档拿到手就能改、能发,而不是黏成一整片文字。

PDF 项目概览转换成结构化 Markdown,标题层级与嵌套列表完整保留

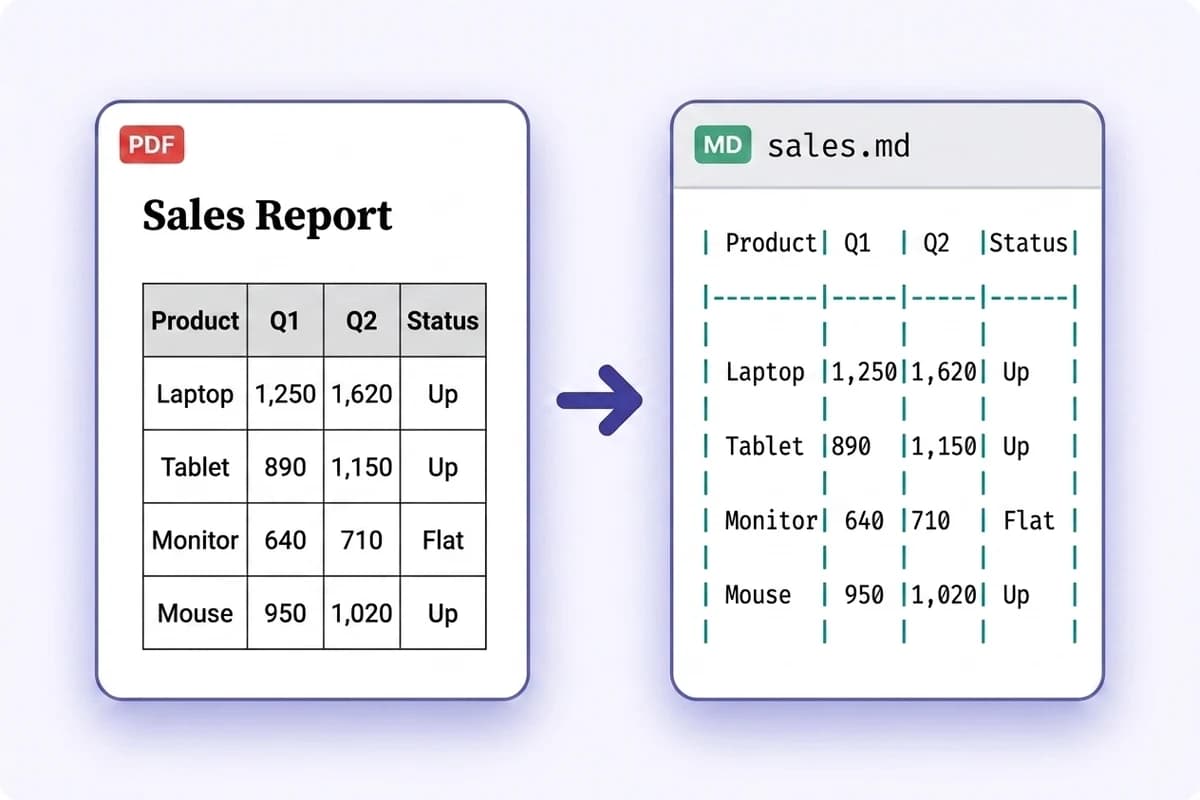
表格变成 Markdown 表格

带框线的表格会重建成竖线表格,列对得整整齐齐。报告、参数表、对比表还能接着用,不会散成零碎文字。

PDF 里的销售表格转换成列对齐的 Markdown 竖线表格

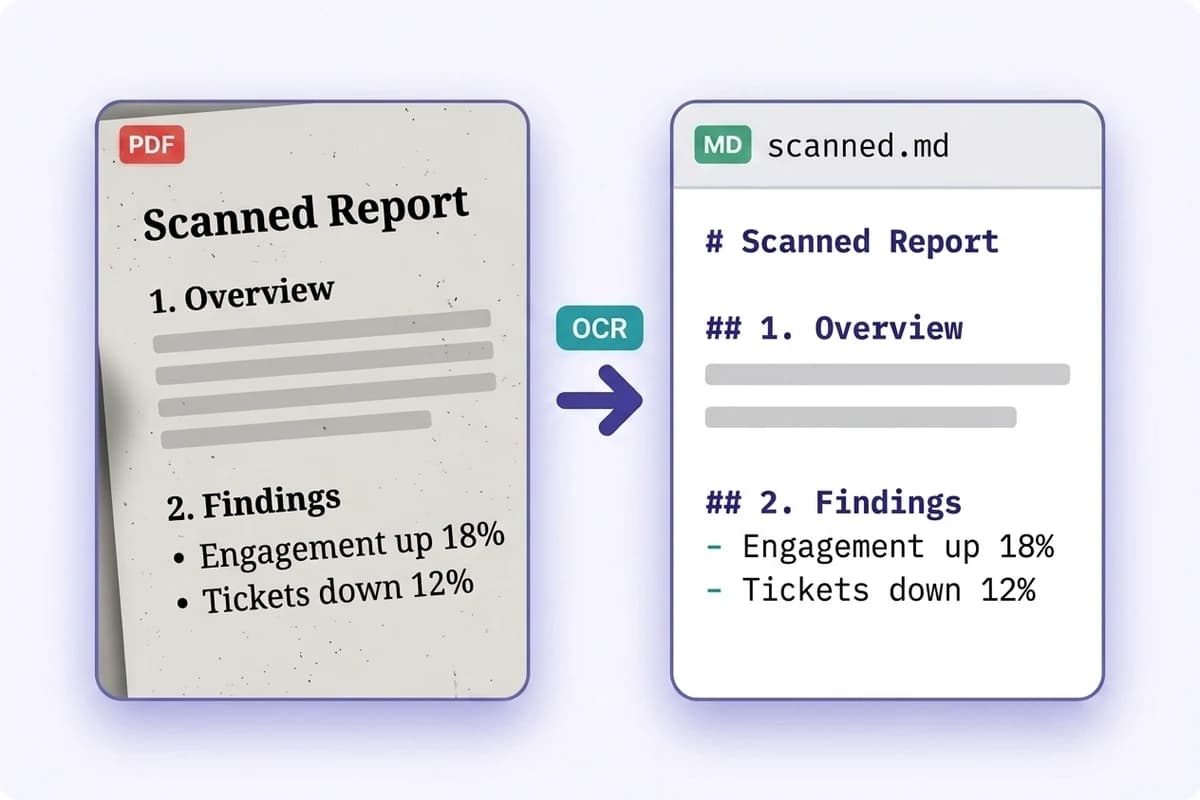
扫描页交给 OCR 读

PDF 没有文字层时,改由 OCR 直接读页面图像:扫描件、拍照的文件、表单都能覆盖,支持 170 多种语言,中日韩都在内。

扫描的纸质报告经 OCR 识别后转换成可编辑的 Markdown

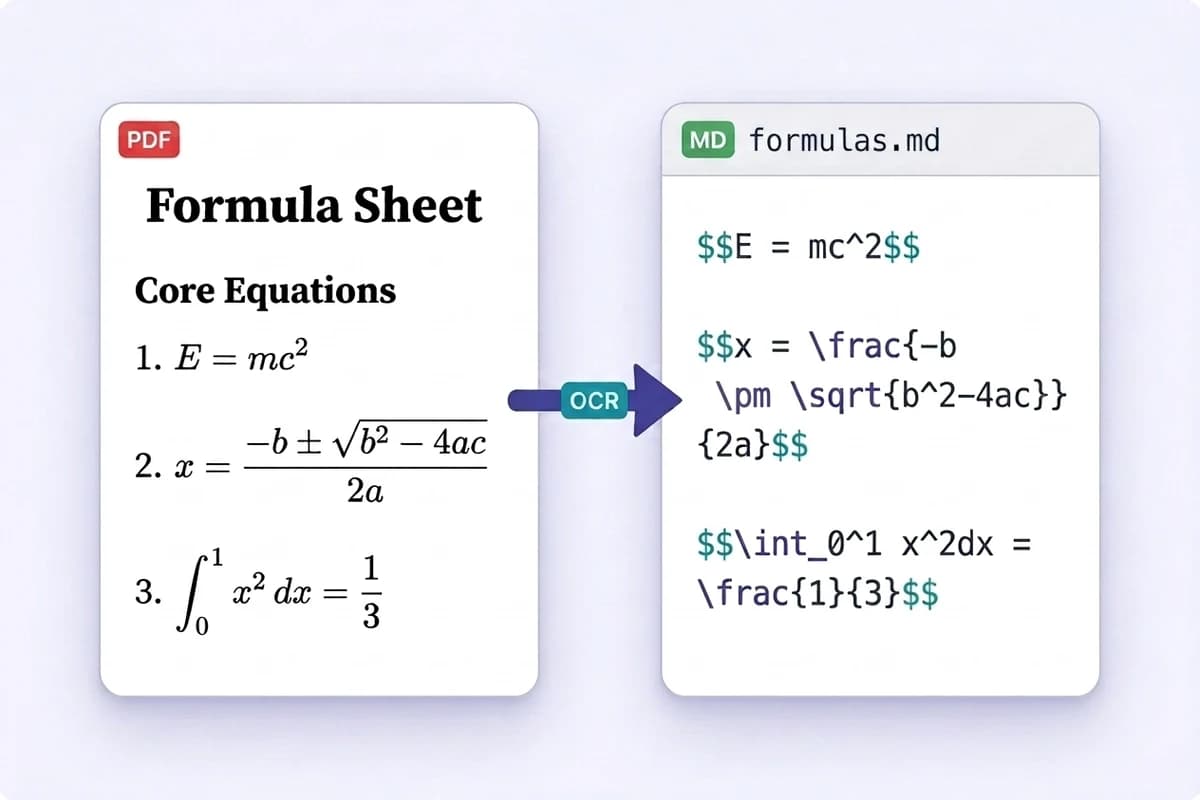
公式以 LaTeX 形式回来

把公式页交给 OCR,数学会以真正的 LaTeX 回到 $$ 块里——分式、根号、积分、上标都保着结构,可以直接贴进 Obsidian、Notion 或论文。(数字版 PDF 把公式存成一个个散落的字形,所以真正能还原它们的是 OCR 这条路。)

PDF 公式页经 OCR 转换成 Markdown,公式包在美元符号块里以 LaTeX 呈现

完整指南:怎么把 PDF 转成 Markdown

为什么有的 PDF 顺顺当当,有的非要 OCR 不可——以及两种情况下怎么拿到最干净的结果。

数字版 PDF 和扫描版 PDF

数字版 PDF —— 有文字层

由软件生成(Word、LaTeX、浏览器的打印对话框)。字符真真切切在文件里,所以提取又快又几乎不丢东西。日常文档里大约 97% 属于这一类,几秒就完事。

扫描版 PDF —— 只是一页页照片

从复印机、手机相机或传真机出来的。没有文字可提,选中复制什么也拿不到。只有 OCR 读得动——这正是多数免费工具悄无声息还你一个空文件的原因。
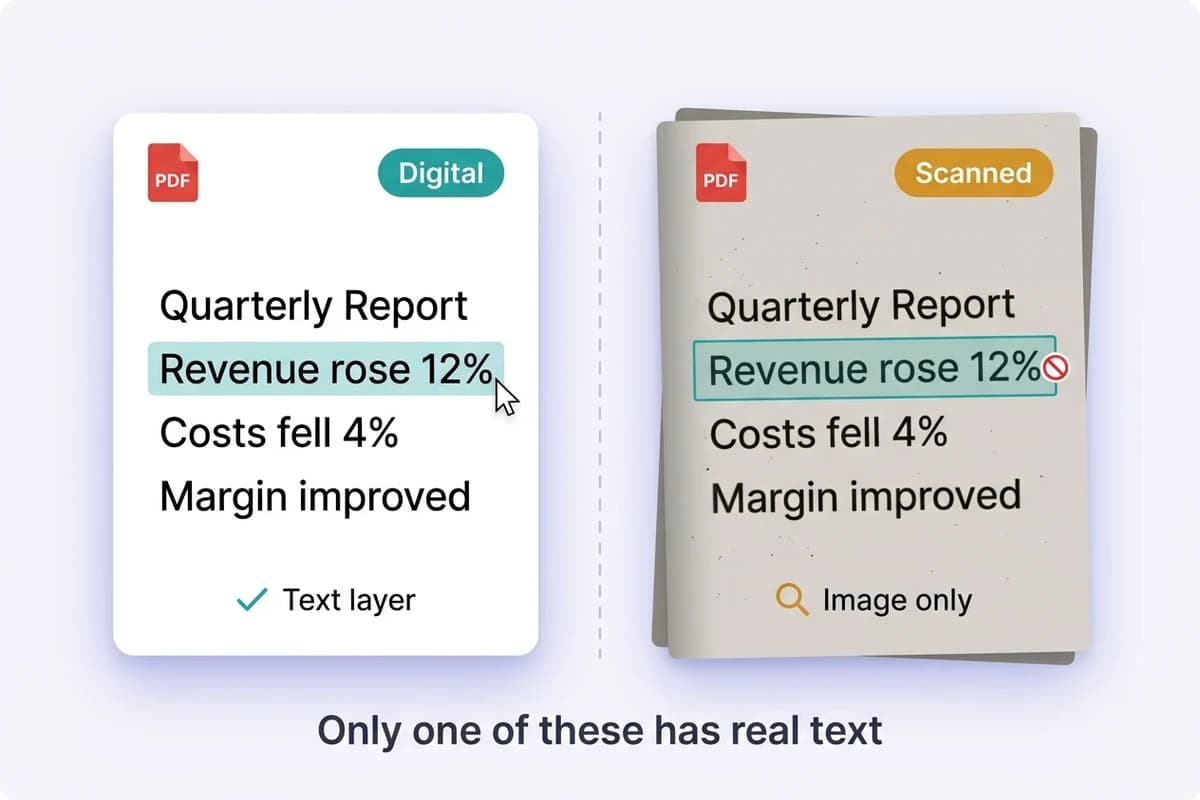
数字版 PDF 与扫描版 PDF 并排对比,标出哪一种需要 OCR

哪些能转得好

单栏文档

报告、技术文档、论文、合同都转得干净:标题保住层级,列表保住嵌套。

带框线的表格

框线看得见的表格会重建成 Markdown 表格,在哪儿打开都显示正常。

内嵌图片

PDF 里的图会被抽出来并在正文中引用,文档不会缺东西。

扫描件和表单

没有文字层的页面由 OCR 识别,多语言排版和填好的表单同样能处理。

怎样才能转得最干净

  1. 1.

    先让自动判定拿主意

    原样传上来就行。工具会先看有没有文字层,只有文件确实需要时才提示 OCR,不会让你为用不上的 OCR 付费。

  2. 2.

    出乱码时手动强制走 OCR

    老扫描件有时带着多年前留下的劣质 OCR 文字层。这种情况骗得过任何自动判定,所以结果页一直留着「改用 OCR 重试」按钮——文字出来是乱的,就点它。

  3. 3.

    多栏页面记得复核

    侧边栏、脚注、双栏论文是按 PDF 内部存储顺序读的,而那个顺序不一定等于人的阅读顺序。这些地方在采信之前先扫一眼。

  4. 4.

    太长的文档拆开转

    页数上限之所以存在,是因为耗时随篇幅增长。书籍或案卷建议按章节转——顺带也更好逐段复核。

Key Capabilities

这个 PDF 转 Markdown 工具能搞定什么

为你还要继续动手改的文档而做,不只是拿来读。

扫描版 PDF 的 OCR 识别

没有文字层的页面从图像里识别:扫描件、照片、表单都能覆盖,支持 170 多种语言,中日韩都在内。

结构原样保留

标题层级、嵌套列表、引用块都以真正的 Markdown 回来,不会压成一团摊平的段落。

表格转成竖线表格

带框线的表格会按列对齐重建,在任何 Markdown 编辑器、wiki 或代码仓库里都显示正常。

公式与图片

内嵌图片跟着文档一起走,扫描的技术页面里的数学记号由 OCR 找回来。

回到 Word

一键把 Markdown 交给 Word 转换器,下载 .docx——PDF 不肯给你的那份可编辑文档,在这儿拿到。

转换完即删除

文件通过加密连接传输,只用于本次转换,之后即被删除。不留存、不分析。

Use Cases

都是谁在用 PDF 转 Markdown

这个工具每天在干的五件事,总有一件跟你的场景对得上。

开发者

把 API 文档、参数表、厂商手册从 PDF 里掏出来,搬进文档站、README 或 wiki——直接能进版本库的 Markdown。

科研人员

把论文变成 Obsidian、Notion、Zotero 里的 Markdown 笔记。扫描版的过刊走 OCR,公式回来的是 LaTeX 而不是一堆乱码。

写作与编辑

从客户报告、简报、新闻资料包里取出干净可编辑的正文,一页都不用重打,然后回到你惯用的 Markdown 编辑器接着写。

学生

把课件、讲义、拍照的笔记转成 Markdown,考前就能搜索、精简、重新编排。拍照的页面交给 OCR。

AI 与 RAG 管线

大模型最吃 Markdown。喂进知识库、微调集或提示词之前先把源 PDF 转一道:结构留住,PDF 那些杂讯不带进来。

Simple Process

PDF 转 Markdown 怎么做

三步搞定,开始不用注册。

01

上传 PDF

把文件拖进来或点选。体积和页数在动手处理之前就先核过,不会让你白等一个注定被拒的文件。

02

数字版还是扫描版,自动认

有文字层的文档立刻开转。要是发现是扫描件,会先问过你再跑 OCR——绝不会悄悄扣费。

03

复制或下载你的 Markdown

看一遍结果,然后复制到剪贴板或下载 .md 文件。扫描件要是出了乱码,一个按钮就能改走 OCR 重跑。

FAQ

PDF 转 Markdown 常见问题

限制、OCR、质量和隐私,直接说清楚。

1

这个 PDF 转 Markdown 工具免费吗?

免费。每位访客每天都有免费转换次数,注册账号还能提高体积和页数上限。扫描件的 OCR 每次转换消耗 1 个积分,因为背后跑的是收费的识别引擎。

2

扫描版 PDF 也能用吗?

能,而这正是它和多数免费工具拉开距离的地方。工具会先看你的 PDF 有没有真正的文字层;没有就提示走 OCR,直接从页面图像里把字认出来。

3

体积和页数的限制是多少?

不登录可以转 10 MB、30 页以内的 PDF。登录后提到 30 MB、150 页,并解锁扫描件的 OCR;订阅用户可达 50 MB、300 页。

4

OCR 支持哪些语言?

170 多种,包括中文、日文、韩文、阿拉伯文和主要欧洲语言。多语言混排的页面一次处理完,不需要事先选语言。

5

表格能保留吗?

带框线的表格能稳定转成 Markdown 表格。无框线表格和大量合并单元格是所有 PDF 解析器的软肋,这些地方在采信之前先核一下。

6

PDF 里的图片会怎么处理?

内嵌图片会被抽出并在 Markdown 中引用,跟着文档一起走。图片特别多的大文件可能会丢弃图片以保证文件还能用,发生时会有提示。

7

支持数学公式吗?

扫描文档里,OCR 能把公式还原成 LaTeX 记法。数字版 PDF 把公式结构存成一个个定位好的字形而非标记语言,所以复杂公式过来就只剩普通字符——这类页面改走 OCR 往往效果更好。

8

为什么我转出来的内容是乱的?

多栏排版、侧边栏和脚注是按 PDF 内部存储顺序读的,而那个顺序不一定符合人的阅读习惯。单栏文档的结果要干净得多。如果是文字本身糊成一团,那多半是文件带着劣质 OCR 文字层——在结果页点「改用 OCR 重试」。

9

我的 PDF 安全吗?

安全。文件通过加密连接传输,只用于你要求的这次转换,处理完成后即从存储中移除。我们不会读取你的文档,绝不会拿去训练模型,也不会出售或公开。上传文件的具体处理方式,隐私政策里写得很清楚。

10

转换 PDF 会消耗积分吗?

登录后每次转换都消耗积分:按每 30 页 1 积分计,不足 30 页也算 1 积分,扫描件的 OCR 同样按此规则。订阅用户不限量。

把那份 PDF 变成能动手改的东西

扫描版也好数字版也好,先转 Markdown,再去 Word、PDF 或 HTML。

即开即用 · 每日免费转换次数 · 扫描版由 OCR 支持