Бесплатно, OCR включён

PDF в Markdown — бесплатно, даже отсканированный

Перед отсканированным PDF большинство конвертеров пасует. Этот распознаёт его и запускает OCR: отчёты, договоры и бланки выходят настоящим Markdown — с таблицами, заголовками и формулами.

Перетащите PDF сюда или нажмите для выбора

До 10 МБ и 30 страниц · войдите, чтобы поднять лимит

Что значит конвертировать PDF в Markdown

Конвертация PDF в Markdown вытаскивает запертые внутри PDF текст и структуру и переписывает их простым текстом: заголовки становятся строками с решёткой, таблицы — таблицами на вертикальных чертах, изображения едут вместе с документом. Сложность в том, что немалая часть PDF — это сканы вообще без текстового слоя, где извлечение не даёт ничего и помогает только OCR. Инструмент сам определяет, какой файл перед ним. Получив Markdown, можно двигаться дальше — в Word (.docx), PDF или HTML.

Три пути от PDF к Markdown

1

Онлайн-конвертеры — загружаете PDF и через секунды получаете Markdown. Лучший выбор, когда нужно сохранить структуру и ничего не устанавливать, и единственный рабочий путь для сканов, которым нужен OCR.

2

Командная строка — библиотеки вроде pymupdf4llm или marker работают локально и поддаются скриптованию для пакетной обработки. Годится разработчикам с большим потоком файлов ценой установки, настройки и отсутствия OCR из коробки.

3

Копировать и вставить — выделить текст в просмотрщике PDF и вставить в редактор. Для одного абзаца сойдёт, но заголовки, таблицы и многоколоночная вёрстка рассыпаются, а со сканов не переносится вообще ничего.

Example Output

Как результат выглядит на самом деле

Четыре вещи, которые этот конвертер делает правильно и которых копирование никогда не даст.

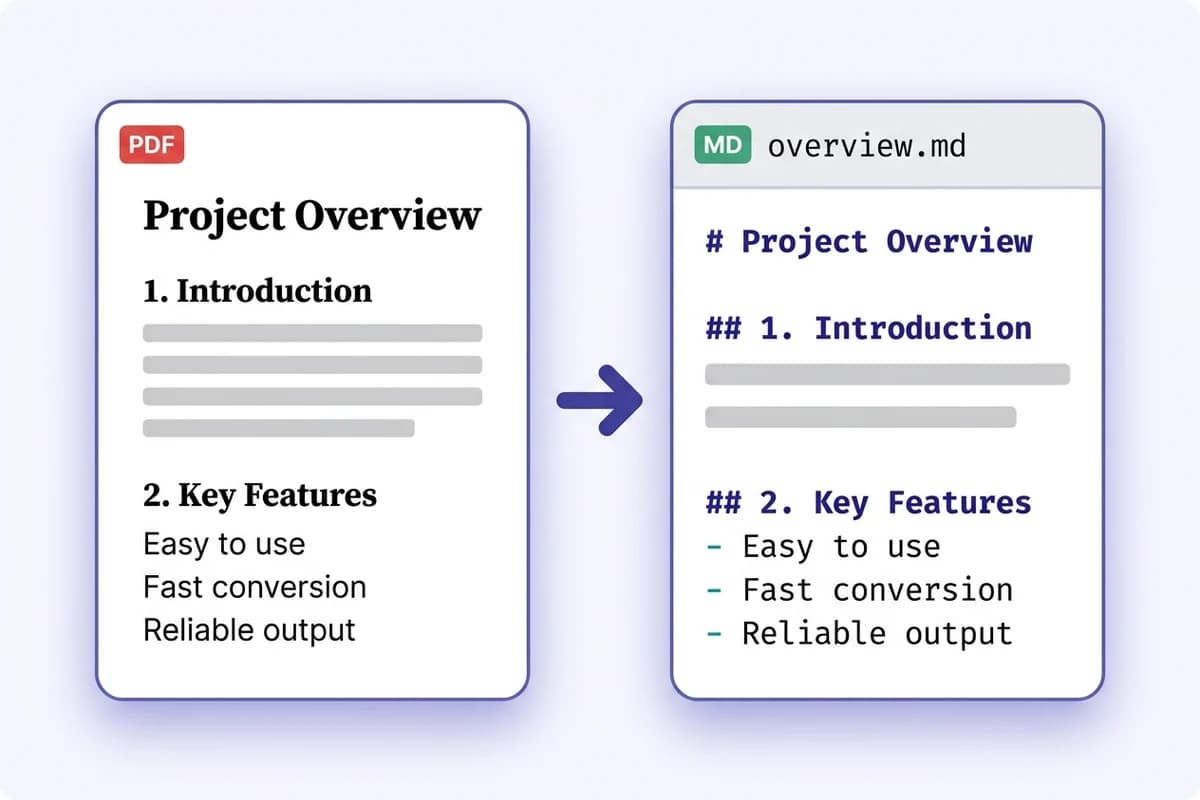
Заголовки и структура держатся

Уровни заголовков, вложенные списки и разбивка на абзацы восстанавливаются настоящим Markdown, так что документ сразу готов к правке или публикации, а не остаётся сплошной стеной текста.

Обзор проекта из PDF, преобразованный в структурированный Markdown с сохранёнными уровнями заголовков и вложенными списками

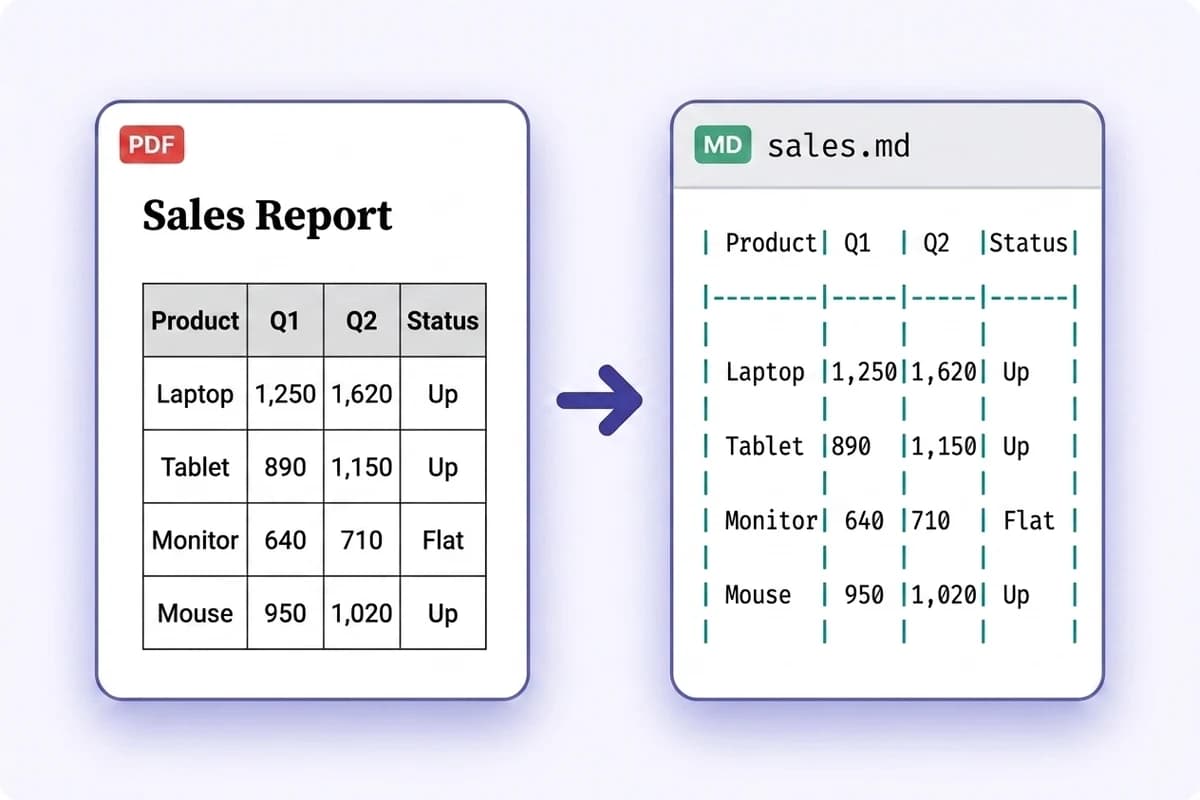
Таблицы становятся таблицами Markdown

Таблицы с рамками пересобираются на вертикальных чертах с выровненными колонками: отчёты, спецификации и сравнения остаются пригодными к повторному использованию, а не расползаются в свободный текст.

Таблица продаж из PDF, преобразованная в таблицу Markdown с выровненными колонками

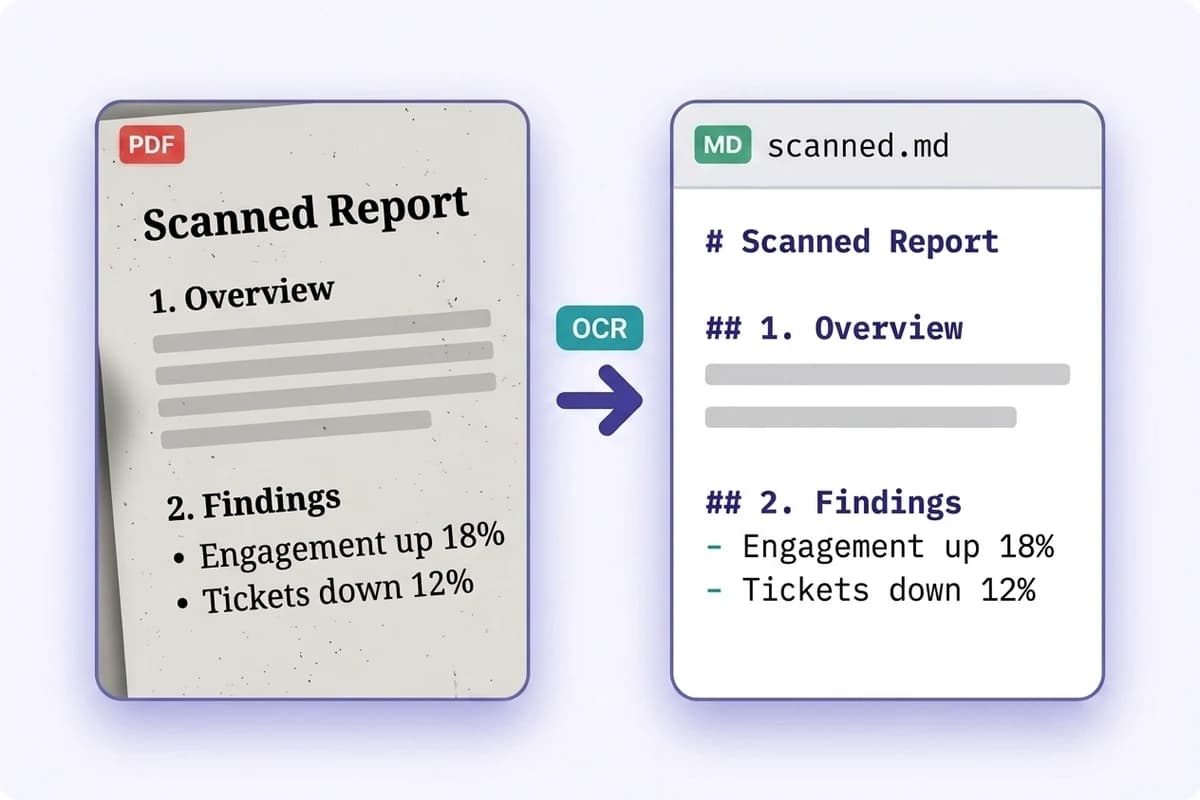
Отсканированные страницы читает OCR

Если у PDF нет текстового слоя, OCR читает изображения страниц: сканы, сфотографированные документы и бланки более чем на 170 языках, включая китайский, японский и корейский.

Отсканированный бумажный отчёт, распознанный через OCR и преобразованный в редактируемый Markdown

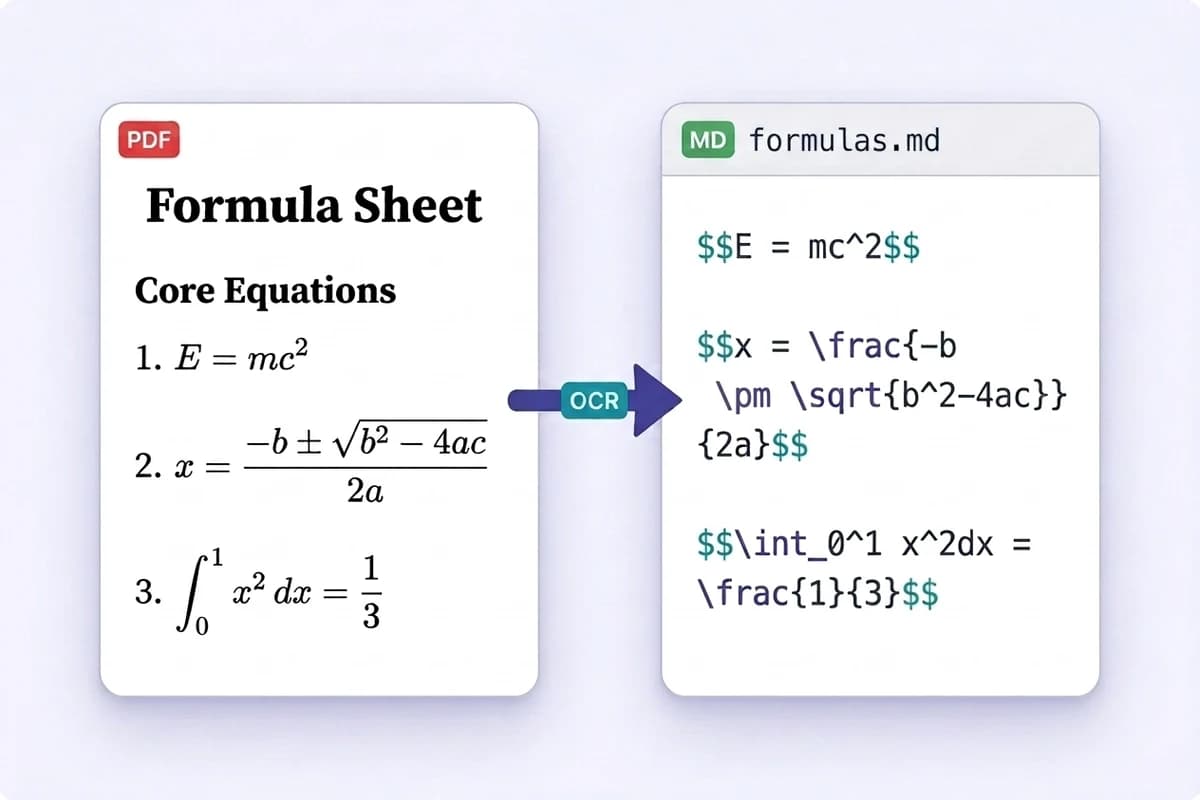
Формулы возвращаются как LaTeX

Прогоните через OCR лист с формулами — и математика вернётся настоящим LaTeX внутри блоков $$: дроби, корни, интегралы и степени сохранят структуру и будут готовы для Obsidian, Notion или статьи. (В цифровых PDF уравнения хранятся отдельными глифами, поэтому именно OCR извлекает их как надо.)

Лист формул из PDF, преобразованный через OCR в Markdown с формулами LaTeX внутри блоков со знаками доллара

Другие конвертеры Markdown

Документ уже в Markdown — отправьте его туда, где он нужен.

Markdown в Word

Превратите только что извлечённый Markdown в полностью оформленный документ Word (.docx): таблицы, формулы и блоки кода сохранены и готовы к правке.

DOCXПолностью редактируемыйЗамыкает круг
Открыть инструмент

Markdown в HTML

Переведите Markdown в чистый семантический HTML5, который можно вставить прямо в CMS, блог или письмо: таблицы GFM, подсветка кода и LaTeX сохраняются.

Семантический HTML5Копировать или скачатьGFM
Открыть инструмент

Редактор Markdown вживую

Приведите извлечённый Markdown в порядок с мгновенным предпросмотром рядом, прежде чем выгружать: поправьте таблицы, формулы и заголовки по ходу.

Мгновенный предпросмотрРядом друг с другомБез регистрации
Открыть инструмент

Markdown в PDF

Превратите извлечённый Markdown в аккуратный PDF, готовый к печати: математика LaTeX, диаграммы Mermaid и блоки кода отрисованы как надо.

Готов к печатиLaTeX и MermaidПиксель в пиксель
Открыть инструмент

Полное руководство: как перевести PDF в Markdown

Почему одни PDF проходят безупречно, а другим нужен OCR — и как получить чистый результат в обоих случаях.

Цифровые PDF и отсканированные PDF

Цифровой PDF — с текстовым слоем

Создан программой (Word, LaTeX, окно печати браузера). Символы действительно лежат внутри файла, поэтому извлечение быстрое и почти без потерь. Так устроено около 97 % повседневных документов, и уходит на это несколько секунд.

Отсканированный PDF — просто снимки страниц

Получен с копира, камеры телефона или факса. Извлекать нечего: выделение и копирование не дают ничего. Прочитать их способен только OCR — именно поэтому большинство бесплатных конвертеров молча отдают пустой файл.
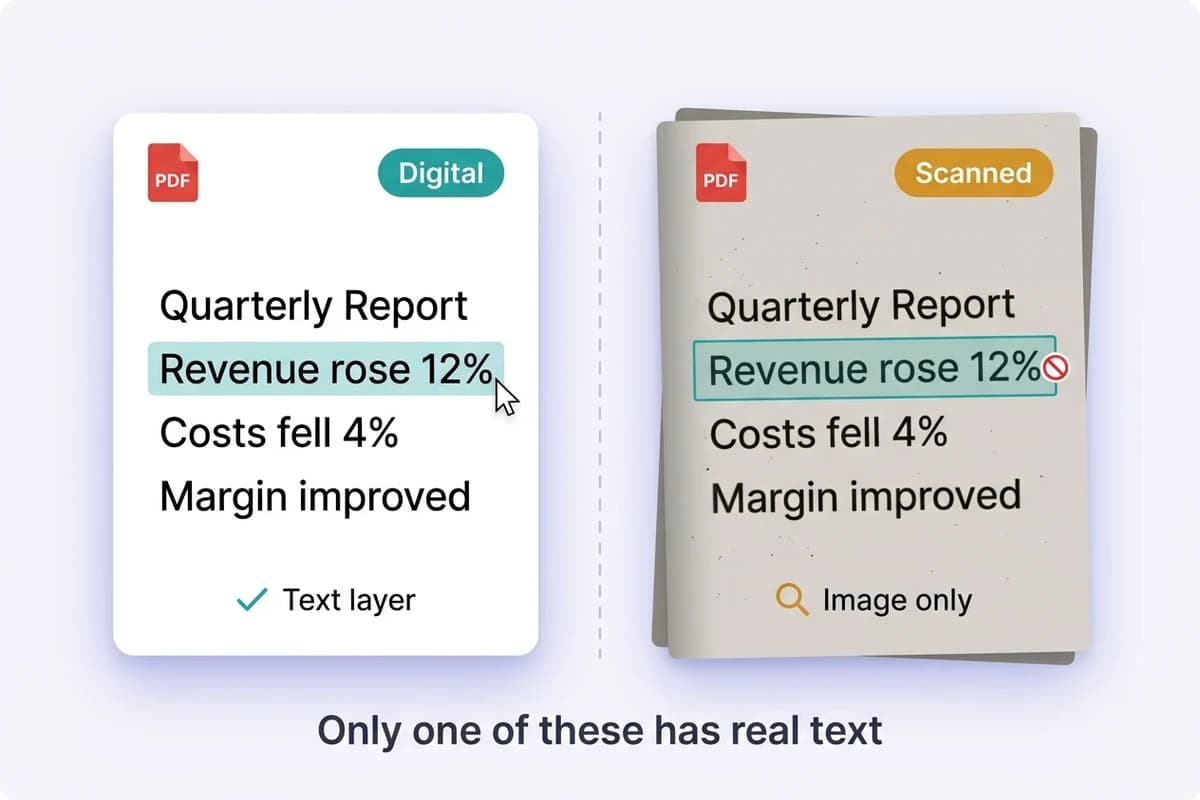
Цифровой и отсканированный PDF рядом друг с другом, с указанием, какому нужен OCR

Что выходит хорошо

Одноколоночные документы

Отчёты, документация, статьи и договоры проходят чисто: заголовки сохраняют уровень, списки — вложенность.

Таблицы с рамками

Таблицы с видимой разлиновкой пересобираются в таблицы Markdown, которые везде отображаются правильно.

Встроенные изображения

Картинки внутри PDF извлекаются и вставляются ссылками в текст, чтобы из документа ничего не пропало.

Сканы и бланки

Страницы без текстового слоя распознаются через OCR, включая многоязычную вёрстку и заполненные бланки.

Как получить самый чистый результат

  1. 1.

    Сначала пусть решит распознавание

    Загружайте файл как есть. Инструмент проверяет наличие текстового слоя и предлагает OCR только тогда, когда он действительно нужен, — вы никогда не платите за лишнее распознавание.

  2. 2.

    Включите OCR принудительно, если вышла белиберда

    Старые сканы иногда тащат за собой плохой слой OCR многолетней давности. На это попадается любое распознавание, поэтому на странице результата остаётся кнопка «запустить OCR» — она и нужна, когда текст приходит покорёженным.

  3. 3.

    Перечитайте многоколоночные страницы

    Боковые врезки, сноски и научные статьи в две колонки читаются в том порядке, в каком их хранит PDF, а он не всегда совпадает с порядком чтения. Пробегите эти места глазами, прежде чем на них опираться.

  4. 4.

    Разбивайте очень длинные документы

    Ограничения по страницам существуют потому, что время растёт вместе с объёмом. Книги и дела удобнее переводить по главам — и вычитывать результат тоже проще.

Key Capabilities

С чем справляется этот конвертер PDF в Markdown

Сделан для документов, с которыми вы собираетесь работать дальше, а не только их читать.

OCR для отсканированных PDF

Страницы без текстового слоя распознаются по изображениям: сканы, фотографии и бланки более чем на 170 языках, включая китайский, японский и корейский.

Структура сохраняется

Уровни заголовков, вложенные списки и цитаты возвращаются настоящим Markdown, а не сплющенной кашей из абзацев.

Таблицы на вертикальных чертах

Таблицы с рамками пересобираются с выровненными колонками и корректно отображаются в любом редакторе Markdown, вики или репозитории.

Формулы и изображения

Встроенные картинки едут вместе с документом, а OCR вытягивает математическую запись с отсканированных технических страниц.

Обратно в Word

Отправьте Markdown в конвертер Word одним щелчком и скачайте .docx — тот самый редактируемый документ, которого PDF вам не давал.

Удаляется после конвертации

Файл передаётся по зашифрованному соединению, используется только для этой конвертации и затем удаляется. Ничего не хранится и не анализируется.

Use Cases

Кому нужен перевод PDF в Markdown

Пять задач, которые этот инструмент решает каждый день, — одна наверняка похожа на вашу.

Разработчикам

Достаньте из PDF описания API, спецификации и руководства вендоров и перенесите их в документацию, README или вики — Markdown, который сразу ложится в систему контроля версий.

Исследователям

Превращайте статьи в заметки Markdown для Obsidian, Notion или Zotero. Отсканированные старые выпуски проходят через OCR, а формулы возвращаются в LaTeX, а не ломаными символами.

Редакторам и авторам

Получите чистый редактируемый текст из клиентских отчётов, брифов и пресс-китов, не перепечатывая ни страницы, и работайте дальше в привычном редакторе Markdown.

Студентам

Переводите слайды лекций, раздаточные материалы и сфотографированные конспекты в Markdown, по которому можно искать, который легко сокращать и пересобирать перед экзаменом. Сфотографированные страницы берёт на себя OCR.

Конвейерам ИИ и RAG

Markdown языковые модели читают лучше всего. Переводите исходные PDF, прежде чем отправлять их в базу знаний, набор для дообучения или запрос: структура сохраняется, шума PDF нет.

Simple Process

Как перевести PDF в Markdown

Три шага, и для начала не нужна учётная запись.

01

Загрузите PDF

Перетащите файл или выберите его на компьютере. Размер и число страниц проверяются до обработки, поэтому вы никогда не ждёте файл, который всё равно отклонят.

02

Цифровой или скан — определит сам

Документы с текстовым слоем конвертируются сразу. Если файл окажется сканом, перед запуском OCR спросят — молча ничего не спишут.

03

Скопируйте или скачайте Markdown

Просмотрите результат и скопируйте его в буфер обмена либо скачайте файл .md. Если скан вышел покорёженным, одна кнопка прогонит его через OCR.

FAQ

Частые вопросы про PDF и Markdown

Ограничения, OCR, качество и конфиденциальность — коротко и по делу.

1

Этот конвертер PDF в Markdown бесплатный?

Да. У каждого посетителя есть бесплатные конвертации каждый день, а учётная запись поднимает лимиты по размеру и числу страниц. OCR для сканов расходует один кредит за конвертацию, потому что за ним стоит платный движок распознавания.

2

Работает ли он с отсканированными PDF?

Работает — и именно это отличает его от большинства бесплатных конвертеров. Инструмент проверяет, есть ли у PDF настоящий текстовый слой; если его нет, предлагает OCR, который читает символы прямо с изображений страниц.

3

Какие ограничения по размеру и числу страниц?

Без учётной записи можно конвертировать PDF до 10 МБ и 30 страниц. После входа — до 30 МБ и 150 страниц, а также открывается OCR для сканов; у подписчиков — до 50 МБ и 300 страниц.

4

Какие языки распознаёт OCR?

Более 170, среди них китайский, японский, корейский, арабский и основные европейские. Страницы со смешанными языками разбираются за один проход — язык заранее выбирать не нужно.

5

Сохраняются ли таблицы?

Таблицы с рамками надёжно превращаются в таблицы Markdown. Таблицы без разлиновки и сильно объединённые ячейки — слабое место любого разборщика PDF, поэтому такие места стоит проверить, прежде чем на них полагаться.

6

Что происходит с изображениями из PDF?

Встроенные изображения извлекаются и вставляются ссылками в Markdown, так что едут вместе с документом. У очень насыщенных картинками PDF изображения могут быть отброшены, чтобы файл остался рабочим, — об этом вам сообщат.

7

Поддерживаются ли математические формулы?

В отсканированных документах OCR возвращает формулы записью LaTeX. В цифровых PDF структура уравнений хранится расставленными глифами, а не разметкой, поэтому сложные формулы приходят простыми символами — прогнать такие страницы через OCR часто выгоднее.

8

Почему результат выглядит перепутанным?

Многоколоночная вёрстка, боковые врезки и сноски читаются в том порядке, в каком их хранит PDF, а он не всегда совпадает с человеческим порядком чтения. Одноколоночные документы дают заметно более чистый результат. Если покорёжен сам текст, у файла, скорее всего, плохой слой OCR — нажмите «запустить OCR» на странице результата.

9

Мой PDF в безопасности?

Да. Файл передаётся по зашифрованному соединению, используется только для запрошенной конвертации и удаляется из хранилища сразу после обработки. Мы не читаем ваши документы, никогда не обучаем на них модели и не продаём и не публикуем их. Как именно обрабатываются загрузки, подробно описано в политике конфиденциальности.

10

Расходуются ли кредиты при конвертации PDF?

После входа каждая конвертация расходует кредиты: 1 кредит за каждые 30 страниц, остаток страниц округляется вверх до полного кредита — то же правило действует для OCR сканов. У подписчиков ограничений нет.

Сделайте из этого PDF то, что можно редактировать

Скан или цифровой — сначала в Markdown, потом в Word, PDF или HTML.

Начать сразу · Бесплатные конвертации каждый день · Сканы обрабатываются через OCR