Grátis – com OCR

Converter PDF para Markdown grátis, inclusive digitalizados

Diante de um PDF digitalizado, a maioria dos conversores desiste. Este reconhece e roda OCR: relatórios, contratos e formulários saem como Markdown de verdade, com tabelas, títulos e fórmulas.

Solte um PDF aqui ou clique para procurar

Até 10 MB e 30 páginas · entre na conta para ampliar o limite

O que é converter PDF para Markdown?

Converter PDF para Markdown é tirar o texto e a estrutura presos dentro do PDF e reescrevê-los como texto puro: os títulos viram linhas com cerquilha, as tabelas viram tabelas de barras verticais e as imagens seguem junto. A parte difícil: boa parte dos PDF são digitalizações sem camada de texto, em que a extração não devolve nada e só o OCR resolve. Esta ferramenta detecta de qual tipo se trata. Com o Markdown em mãos você segue para Word (.docx), PDF ou HTML.

Três caminhos de PDF para Markdown

1

Conversores online: você envia o PDF e em segundos tem o Markdown. A melhor escolha para preservar a estrutura sem instalar nada, e o único caminho viável para digitalizações que precisam de OCR.

2

Linha de comando: bibliotecas como pymupdf4llm ou marker rodam localmente e podem ser automatizadas em lote. Boa opção para quem programa e trata muitos arquivos, ao custo de instalação, ajuste fino e nenhum OCR de fábrica.

3

Copiar e colar: selecionar o texto no leitor de PDF e colar num editor. Serve para um parágrafo, mas títulos, tabelas e layouts em várias colunas desmoronam, e das páginas digitalizadas não sai nada.

Example Output

Como o resultado fica de verdade

Quatro coisas que este conversor acerta e que copiar e colar nunca vai conseguir.

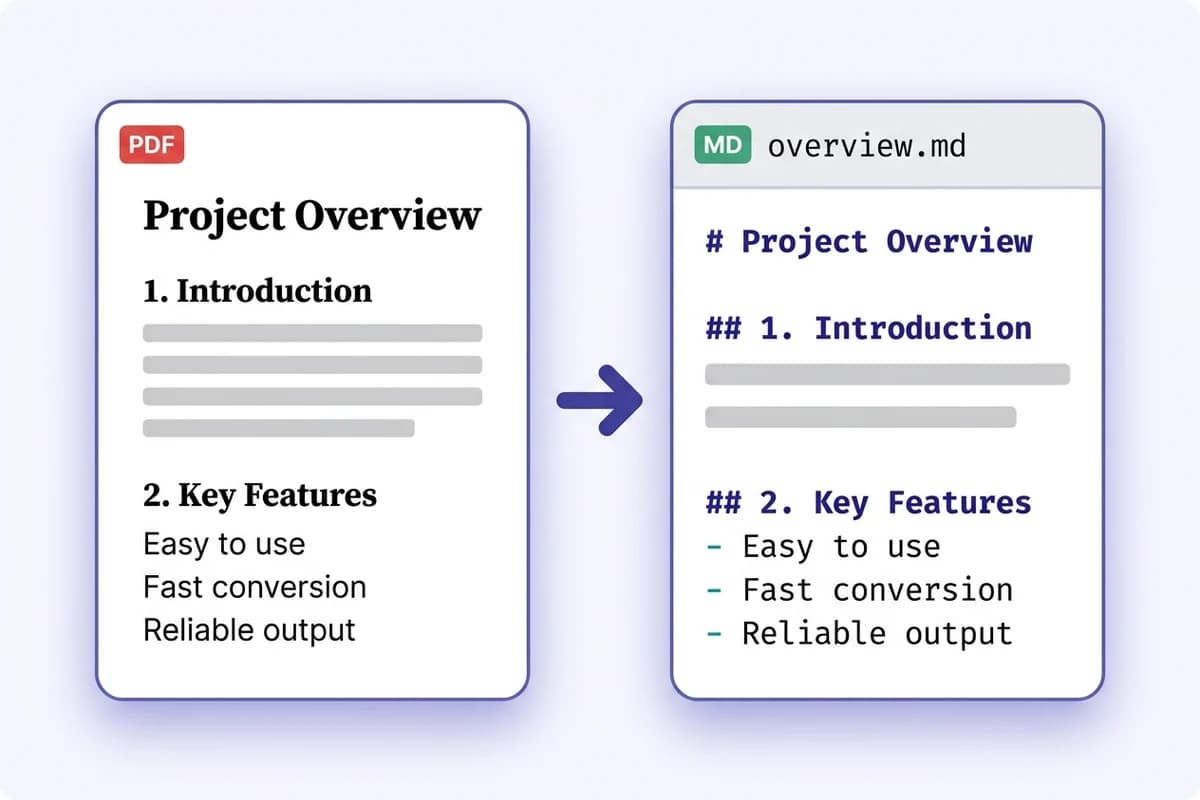
Títulos e estrutura se mantêm

Níveis de título, listas aninhadas e quebras de parágrafo são reconstruídos como Markdown de verdade, então o documento já sai pronto para editar ou publicar em vez de virar um paredão de texto.

Uma visão geral de projeto em PDF convertida em Markdown estruturado, com níveis de título e listas aninhadas preservados

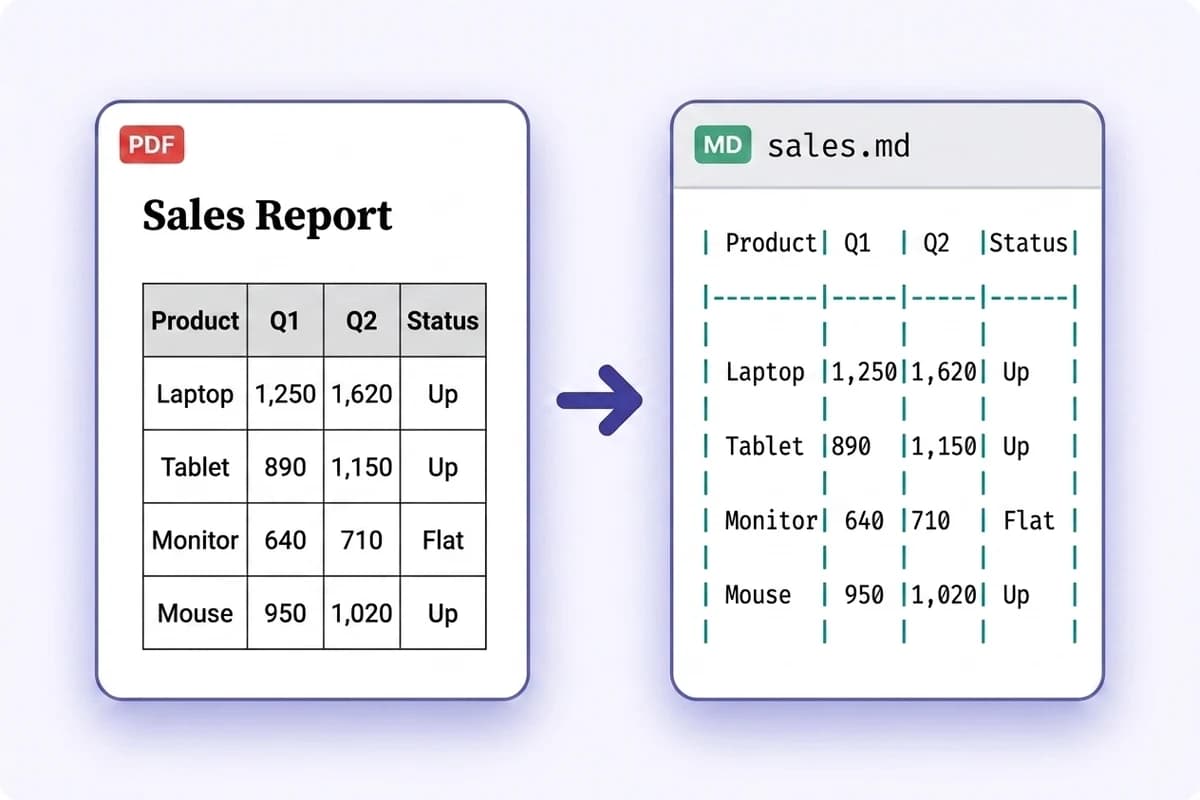
Tabelas viram tabelas de Markdown

Tabelas com bordas são refeitas com barras verticais e colunas alinhadas: relatórios, especificações e comparativos continuam reaproveitáveis em vez de se dissolverem em texto solto.

Uma tabela de vendas de um PDF convertida em tabela de Markdown com colunas alinhadas

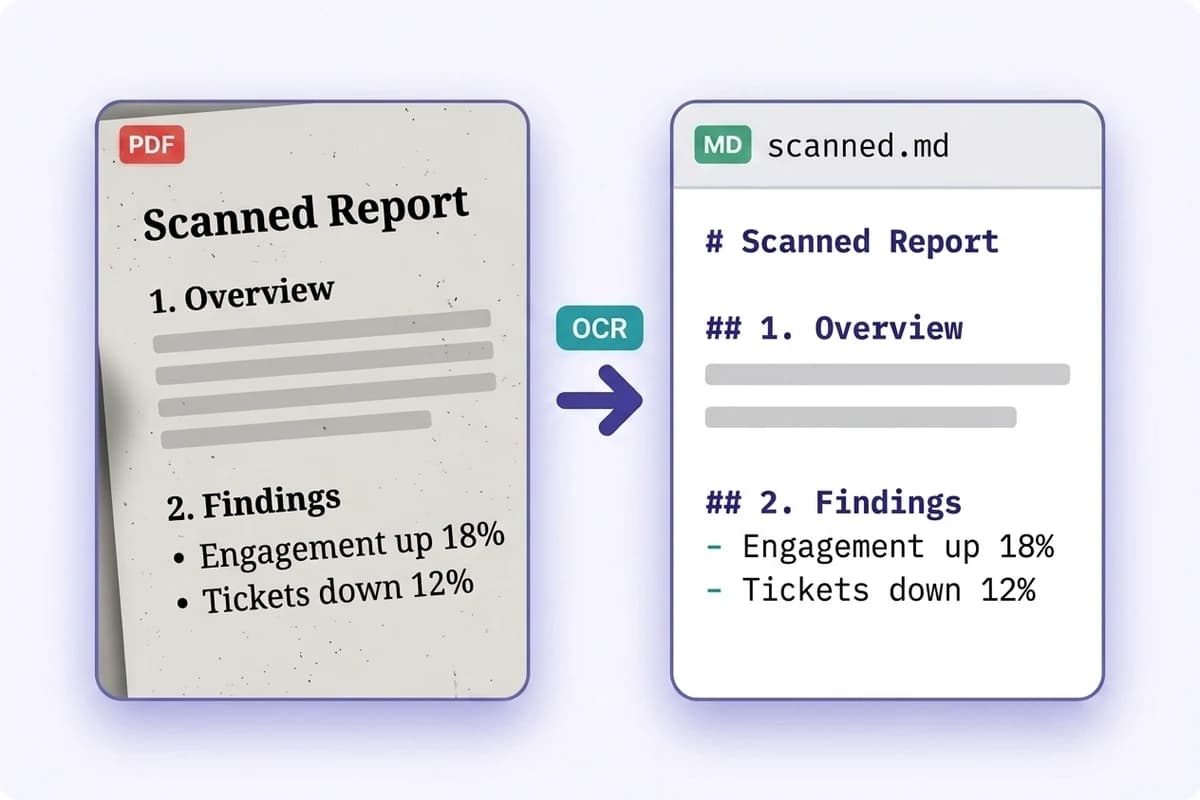
Páginas digitalizadas lidas com OCR

Quando o PDF não tem camada de texto, o OCR lê as imagens das páginas: digitalizações, documentos fotografados e formulários em mais de 170 idiomas, incluindo chinês, japonês e coreano.

Um relatório em papel digitalizado, reconhecido por OCR e convertido em Markdown editável

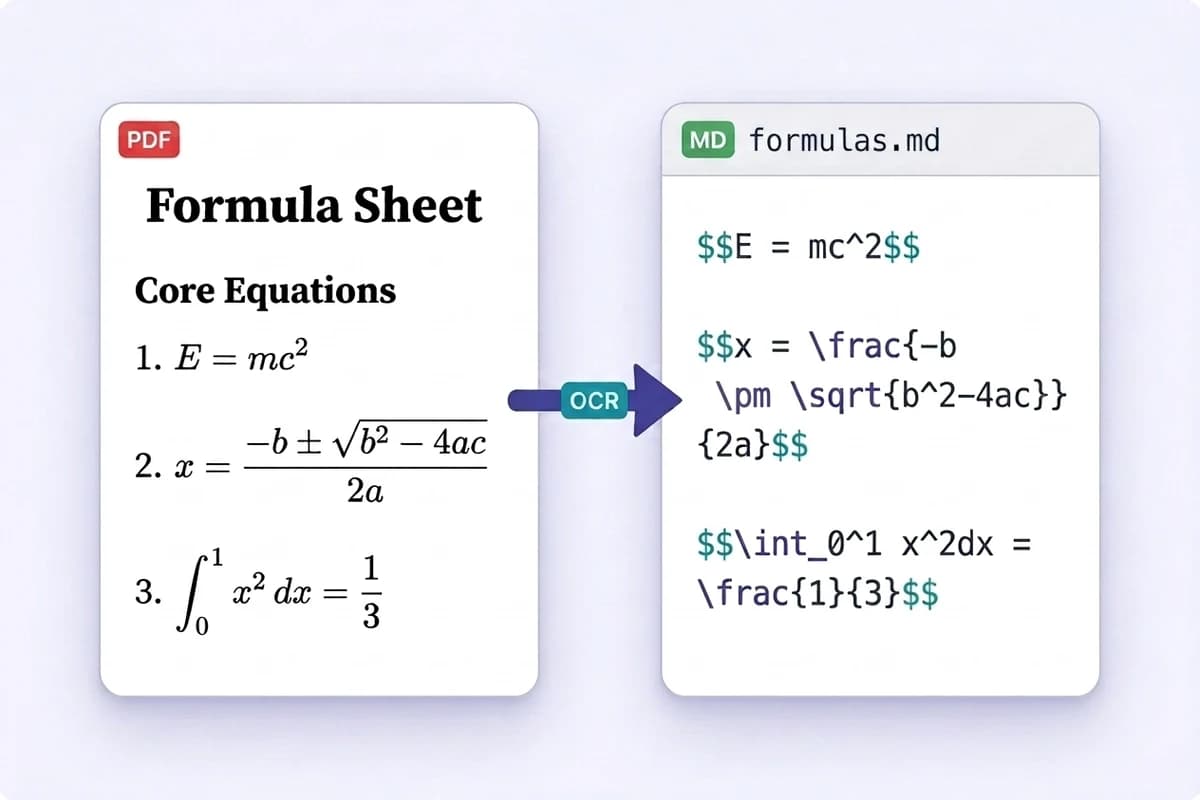
Fórmulas voltam em LaTeX

Passe uma folha de fórmulas pelo OCR e a matemática volta como LaTeX de verdade dentro de blocos $$: frações, raízes, integrais e expoentes mantêm a estrutura, prontos para Obsidian, Notion ou um artigo. (Em PDF digitais as equações ficam guardadas como glifos soltos, por isso o OCR é o caminho que as recupera direito.)

Uma folha de fórmulas em PDF convertida por OCR em Markdown com equações LaTeX entre blocos de cifrão

Guia completo: converter PDF para Markdown

Por que alguns PDF saem impecáveis e outros exigem OCR, e como obter o resultado mais limpo nos dois casos.

PDF digitais e PDF digitalizados

PDF digital: tem camada de texto

Foi gerado por um programa (Word, LaTeX, a caixa de impressão do navegador). Os caracteres estão realmente no arquivo, então a extração é rápida e quase sem perdas. É o caso de cerca de 97 % dos documentos do dia a dia, e leva segundos.

PDF digitalizado: só imagens de páginas

Saiu de uma copiadora, da câmera do celular ou de um fax. Não há texto para extrair: selecionar e copiar não devolve nada. Só o OCR consegue ler, e é exatamente por isso que a maioria dos conversores gratuitos entrega calado um arquivo vazio.
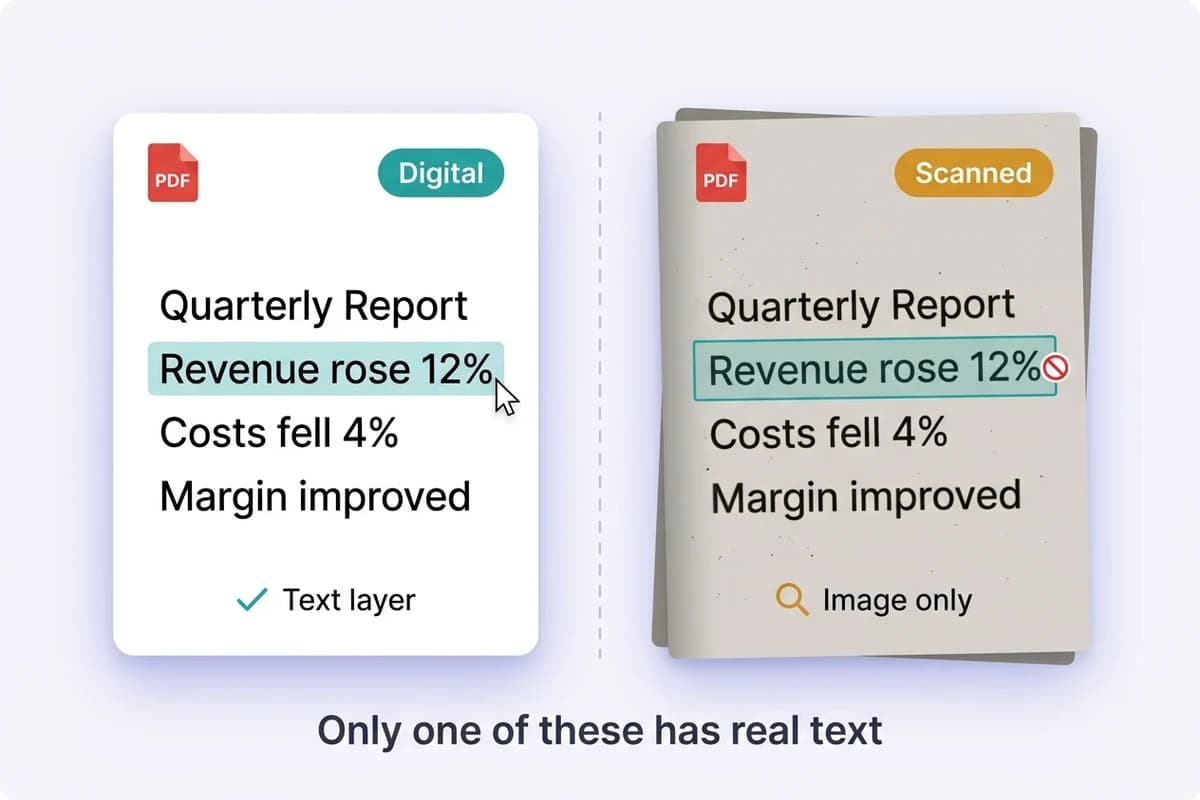
PDF digital e PDF digitalizado comparados lado a lado, indicando qual precisa de OCR

O que sai bem

Documentos de uma coluna

Relatórios, documentação, artigos e contratos saem limpos: os títulos mantêm o nível e as listas continuam aninhadas.

Tabelas com bordas

Tabelas com linhas visíveis são refeitas como tabelas de Markdown que aparecem corretamente em qualquer lugar.

Imagens embutidas

As imagens dentro do PDF são extraídas e referenciadas no texto, para que nada do documento se perca.

Digitalizações e formulários

Páginas sem camada de texto são reconhecidas com OCR, incluindo layouts multilíngues e formulários preenchidos.

Como conseguir o resultado mais limpo

  1. 1.

    Deixe a detecção decidir primeiro

    Envie o arquivo como está. A ferramenta verifica se há camada de texto e só oferece OCR quando o arquivo realmente precisa, então você nunca paga por um OCR desnecessário.

  2. 2.

    Force o OCR se sair ilegível

    Digitalizações antigas às vezes carregam uma camada de OCR ruim de anos atrás. Isso engana qualquer detecção, por isso a página de resultado mantém um botão de «rodar OCR»: use quando o texto sair corrompido.

  3. 3.

    Revise as páginas de várias colunas

    Barras laterais, notas de rodapé e artigos em duas colunas são lidos na ordem em que o PDF os guarda, que nem sempre é a ordem de leitura. Passe os olhos nessas partes antes de confiar.

  4. 4.

    Divida documentos muito longos

    Os limites de páginas existem porque o tempo cresce com a extensão. Para livros ou processos, converta por capítulos: a revisão também fica bem mais fácil.

Key Capabilities

O que este conversor de PDF para Markdown dá conta

Feito para documentos em que você pretende continuar trabalhando, não apenas ler.

OCR para PDF digitalizados

Páginas sem camada de texto são reconhecidas a partir das imagens: digitalizações, fotos e formulários em mais de 170 idiomas, incluindo chinês, japonês e coreano.

Estrutura preservada

Níveis de título, listas aninhadas e citações voltam como Markdown de verdade, não como uma massa de parágrafos achatados.

Tabelas com barras verticais

Tabelas com bordas são refeitas com colunas alinhadas e aparecem corretamente em qualquer editor de Markdown, wiki ou repositório.

Fórmulas e imagens

As imagens embutidas seguem com o documento, e o OCR recupera a notação matemática de páginas técnicas digitalizadas.

De volta ao Word

Mande o Markdown para o conversor do Word com um clique e baixe um .docx: o documento editável que o PDF negava.

Apagado após a conversão

Seu arquivo trafega por uma conexão criptografada, serve apenas para esta conversão e depois é apagado. Nada é guardado nem analisado.

Use Cases

Quem converte PDF para Markdown

Cinco tarefas que esta ferramenta resolve todo dia; alguma vai parecer com a sua.

Quem desenvolve

Tire do PDF referências de API, fichas técnicas e manuais de fornecedor e leve para o site de documentação, o README ou o wiki: Markdown que entra direto no controle de versão.

Pesquisa

Transforme artigos em notas de Markdown para Obsidian, Notion ou Zotero. Edições antigas digitalizadas passam pelo OCR e as equações voltam em LaTeX em vez de caracteres quebrados.

Redação e edição

Consiga texto limpo e editável de relatórios de cliente, briefings e kits de imprensa sem redigitar uma página, e continue no editor de Markdown que você já usa.

Estudantes

Converta slides de aula, apostilas e anotações fotografadas em Markdown que dá para buscar, resumir e reorganizar antes da prova. Das páginas fotografadas cuida o OCR.

Fluxos de IA e RAG

Markdown é o que os modelos de linguagem leem melhor. Converta os PDF de origem antes de alimentar uma base de conhecimento, um conjunto de ajuste fino ou um prompt: estrutura preservada, sem o ruído do PDF.

Simple Process

Como converter PDF para Markdown

Três passos, e não precisa de conta para começar.

01

Envie seu PDF

Arraste o arquivo ou procure no computador. Tamanho e número de páginas são conferidos antes de qualquer processamento, então você nunca espera por um arquivo que será recusado.

02

Digital ou digitalizado: detectado para você

Documentos com camada de texto convertem na hora. Se o arquivo for uma digitalização, você é consultado antes de o OCR rodar: nunca há cobrança silenciosa.

03

Copie ou baixe seu Markdown

Confira o resultado e copie para a área de transferência ou baixe o arquivo .md. Se uma digitalização sair corrompida, um botão passa tudo de novo pelo OCR.

FAQ

Perguntas frequentes sobre PDF para Markdown

Limites, OCR, qualidade e privacidade, explicados sem rodeios.

1

Este conversor de PDF para Markdown é grátis?

É. Todo visitante tem conversões gratuitas por dia, e criar uma conta aumenta os limites de tamanho e de páginas. O OCR de arquivos digitalizados consome um crédito por conversão, porque por trás há um motor de reconhecimento pago.

2

Funciona com PDF digitalizados?

Funciona, e é justamente isso que o separa da maioria dos conversores gratuitos. A ferramenta verifica se o PDF tem uma camada de texto de verdade; se não tiver, oferece OCR, que lê os caracteres a partir das imagens das páginas.

3

Quais são os limites de tamanho e de páginas?

Sem conta dá para converter PDF de até 10 MB e 30 páginas. Entrando na conta sobe para 30 MB e 150 páginas e libera o OCR para arquivos digitalizados, enquanto assinantes chegam a 50 MB e 300 páginas.

4

Quais idiomas o OCR reconhece?

Mais de 170, entre eles chinês, japonês, coreano, árabe e os principais idiomas europeus. Páginas com vários idiomas são resolvidas numa passada só: você não precisa escolher idioma antes.

5

As tabelas são preservadas?

Tabelas com bordas viram tabelas de Markdown de forma confiável. Tabelas sem linhas e células muito mescladas são o ponto fraco de qualquer analisador de PDF, então confira essas partes antes de confiar.

6

O que acontece com as imagens do PDF?

As imagens embutidas são extraídas e referenciadas no Markdown, então seguem com o documento. Em PDF muito carregados de imagens elas podem ser descartadas para o arquivo continuar utilizável, e você é avisado quando isso ocorre.

7

Há suporte a fórmulas matemáticas?

Em documentos digitalizados, o OCR devolve as fórmulas em notação LaTeX. Em PDF digitais a estrutura das equações fica guardada como glifos posicionados em vez de marcação, então fórmulas complexas chegam como caracteres simples: passar essas páginas pelo OCR costuma dar um resultado melhor.

8

Por que meu resultado saiu embaralhado?

Layouts de várias colunas, barras laterais e notas de rodapé são lidos na ordem em que o PDF os guarda, que nem sempre bate com a ordem em que uma pessoa lê. Documentos de uma coluna dão resultados bem mais limpos. Se o próprio texto sair corrompido, o arquivo provavelmente carrega uma camada de OCR ruim: use «rodar OCR» na página de resultado.

9

Meu PDF está seguro?

Está. Seu arquivo trafega por uma conexão criptografada, serve apenas para a conversão que você pediu e é retirado do armazenamento assim que o processamento termina. Não lemos seus documentos, nunca os usamos para treinar modelos e não os vendemos nem publicamos. Nossa política de privacidade detalha exatamente como os envios são tratados.

10

Converter um PDF consome créditos?

Com a conta, toda conversão consome créditos: 1 crédito a cada 30 páginas, com as páginas restantes arredondadas para um crédito inteiro — a mesma regra vale para o OCR de arquivos digitalizados. Assinantes convertem sem limites.

Transforme esse PDF em algo que dá para editar

Digitalizado ou digital: primeiro para Markdown, depois para Word, PDF ou HTML.

Comece na hora · Conversões gratuitas todo dia · PDF digitalizados com OCR