Gratis – OCR incluso

Convertire da PDF a Markdown gratis, anche le scansioni

Davanti a un PDF scansionato la maggior parte dei convertitori si arrende. Questo lo riconosce e avvia l'OCR: relazioni, contratti e moduli escono come vero Markdown, con tabelle, titoli e formule.

Trascina qui un PDF oppure fai clic per cercarlo

Fino a 10 MB e 30 pagine · accedi per alzare il limite

Che cosa vuol dire convertire un PDF in Markdown?

Convertire un PDF in Markdown significa estrarre testo e struttura chiusi dentro il PDF e riscriverli come testo semplice: i titoli diventano righe con il cancelletto, le tabelle diventano tabelle a barre verticali e le immagini viaggiano insieme al documento. Il punto delicato: buona parte dei PDF sono scansioni senza alcun livello di testo, dove l'estrazione non restituisce nulla e solo l'OCR può aiutare. Questo strumento riconosce di quale tipo si tratta. Una volta ottenuto il Markdown puoi proseguire verso Word (.docx), PDF o HTML.

Tre modi per passare da PDF a Markdown

1

Convertitori online: carichi un PDF e in pochi secondi hai il Markdown. La scelta migliore se vuoi conservare la struttura senza installare nulla, e l'unica via praticabile per le scansioni che richiedono OCR.

2

Riga di comando: librerie come pymupdf4llm o marker lavorano in locale e si possono automatizzare per l'elaborazione in blocco. Adatte a chi sviluppa e tratta molti file, al prezzo di installazione, messa a punto e nessun OCR di serie.

3

Copia e incolla: selezionare il testo in un lettore PDF e incollarlo in un editor. Va bene per un paragrafo, ma titoli, tabelle e impaginazioni su più colonne si sfaldano, e dalle pagine scansionate non esce nulla.

Example Output

Come viene davvero il risultato

Quattro cose che questo convertitore fa bene e che un copia e incolla non otterrà mai.

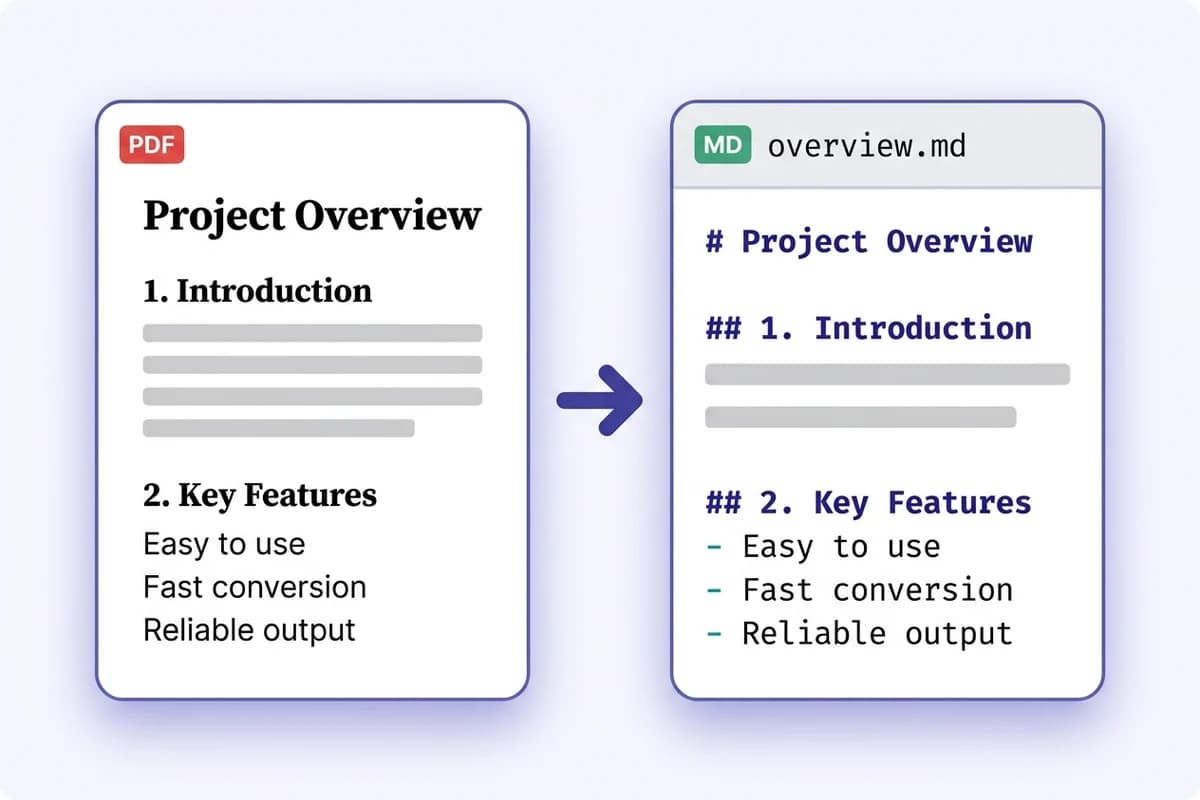
Titoli e struttura reggono

Livelli di titolo, elenchi annidati e stacchi di paragrafo vengono ricostruiti come Markdown vero: il documento è pronto da modificare o pubblicare, non un muro di testo.

Una panoramica di progetto in PDF convertita in Markdown strutturato, con livelli di titolo ed elenchi annidati conservati

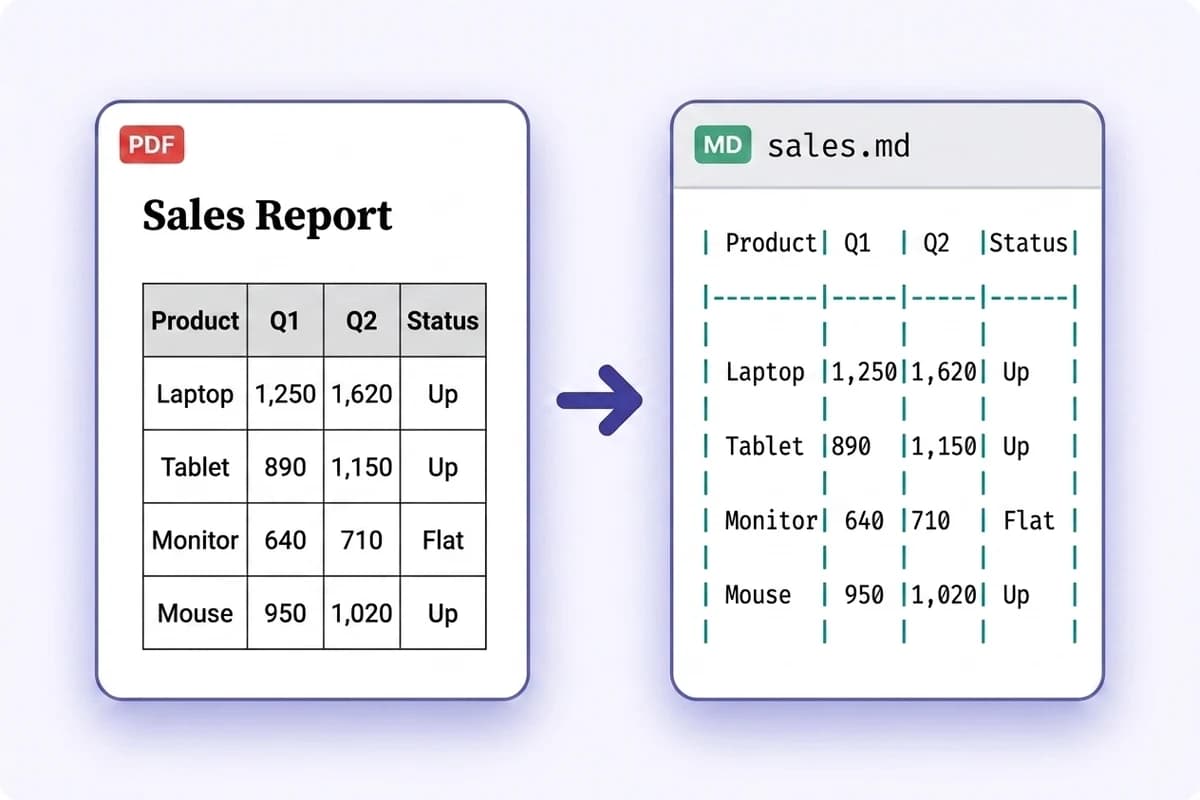
Le tabelle diventano tabelle Markdown

Le tabelle con i bordi vengono ricostruite a barre verticali con le colonne allineate: relazioni, specifiche e confronti restano riutilizzabili invece di sciogliersi in testo sparso.

Una tabella di vendite tratta da un PDF, convertita in tabella Markdown con colonne allineate

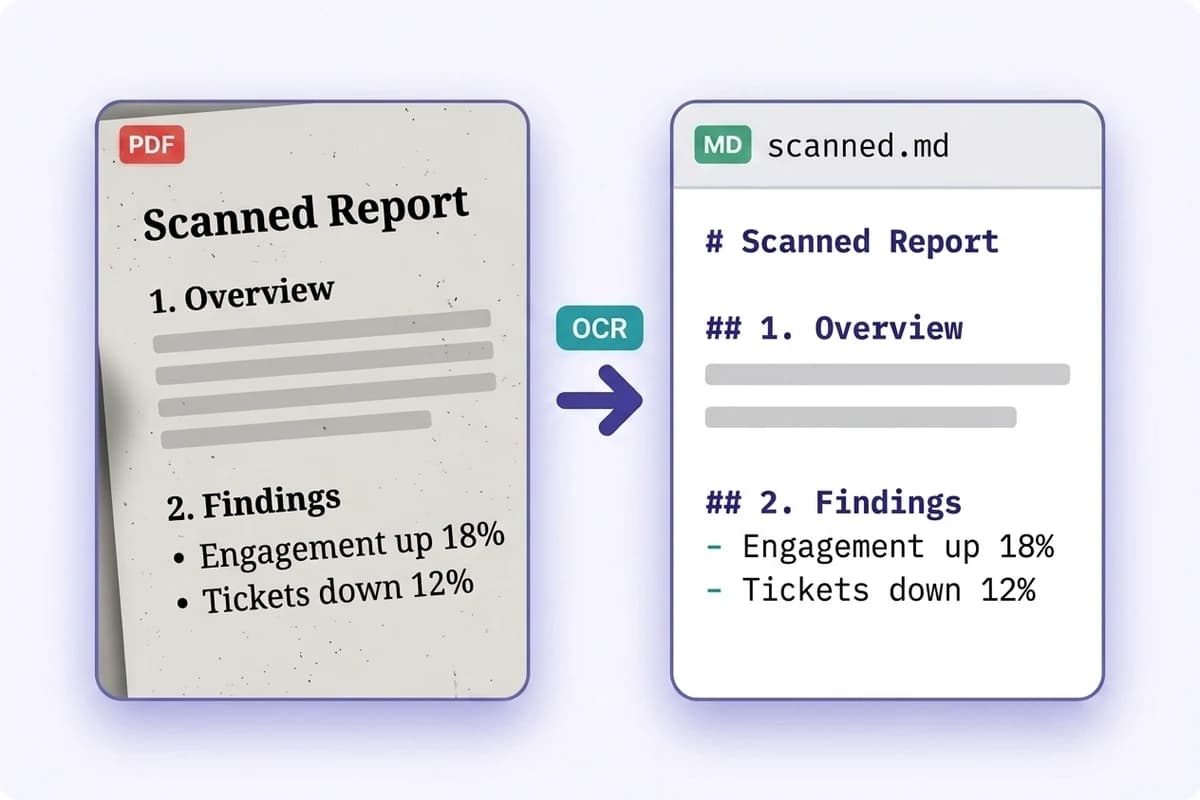
Pagine scansionate lette con OCR

Quando un PDF non ha livello di testo, l'OCR legge le immagini delle pagine: scansioni, documenti fotografati e moduli in oltre 170 lingue, cinese, giapponese e coreano compresi.

Una relazione cartacea scansionata, riconosciuta tramite OCR e convertita in Markdown modificabile

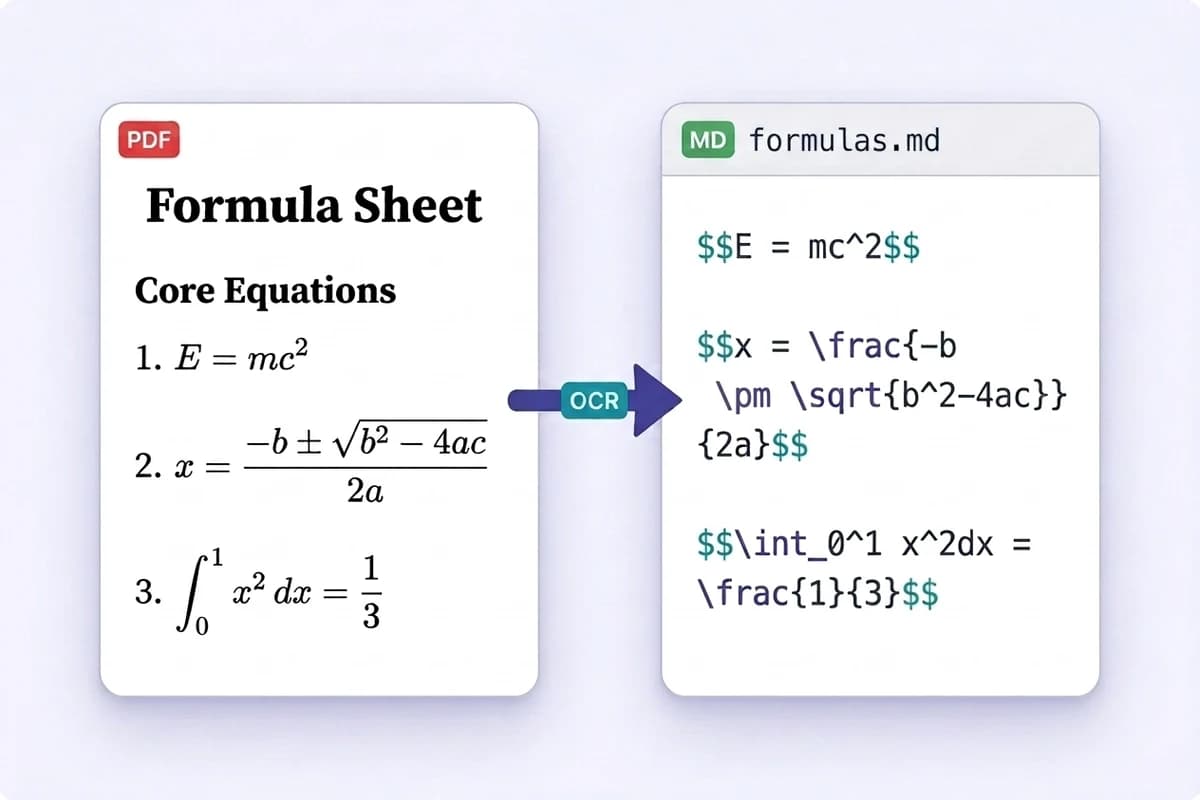
Le formule tornano in LaTeX

Passa un formulario all'OCR e la matematica torna come LaTeX vero dentro blocchi $$: frazioni, radici, integrali ed esponenti mantengono la struttura, pronti per Obsidian, Notion o un articolo. (Nei PDF digitali le equazioni sono salvate come glifi sparsi, perciò l'OCR è la strada che le recupera davvero.)

Un formulario in PDF convertito tramite OCR in Markdown con equazioni LaTeX dentro blocchi di simboli dollaro

Guida completa: convertire un PDF in Markdown

Perché certi PDF escono impeccabili e altri richiedono l'OCR, e come ottenere il risultato più pulito in entrambi i casi.

PDF digitali e PDF scansionati

PDF digitale: ha un livello di testo

Generato da un programma (Word, LaTeX, la finestra di stampa del browser). I caratteri sono davvero dentro il file, quindi l'estrazione è rapida e quasi senza perdite. Vale per circa il 97 % dei documenti di tutti i giorni e richiede pochi secondi.

PDF scansionato: solo immagini di pagine

Prodotto da una fotocopiatrice, dalla fotocamera del telefono o da un fax. Non c'è testo da estrarre: selezionare e copiare non restituisce nulla. Solo l'OCR sa leggerli, ed è esattamente per questo che la maggior parte dei convertitori gratuiti restituisce in silenzio un file vuoto.
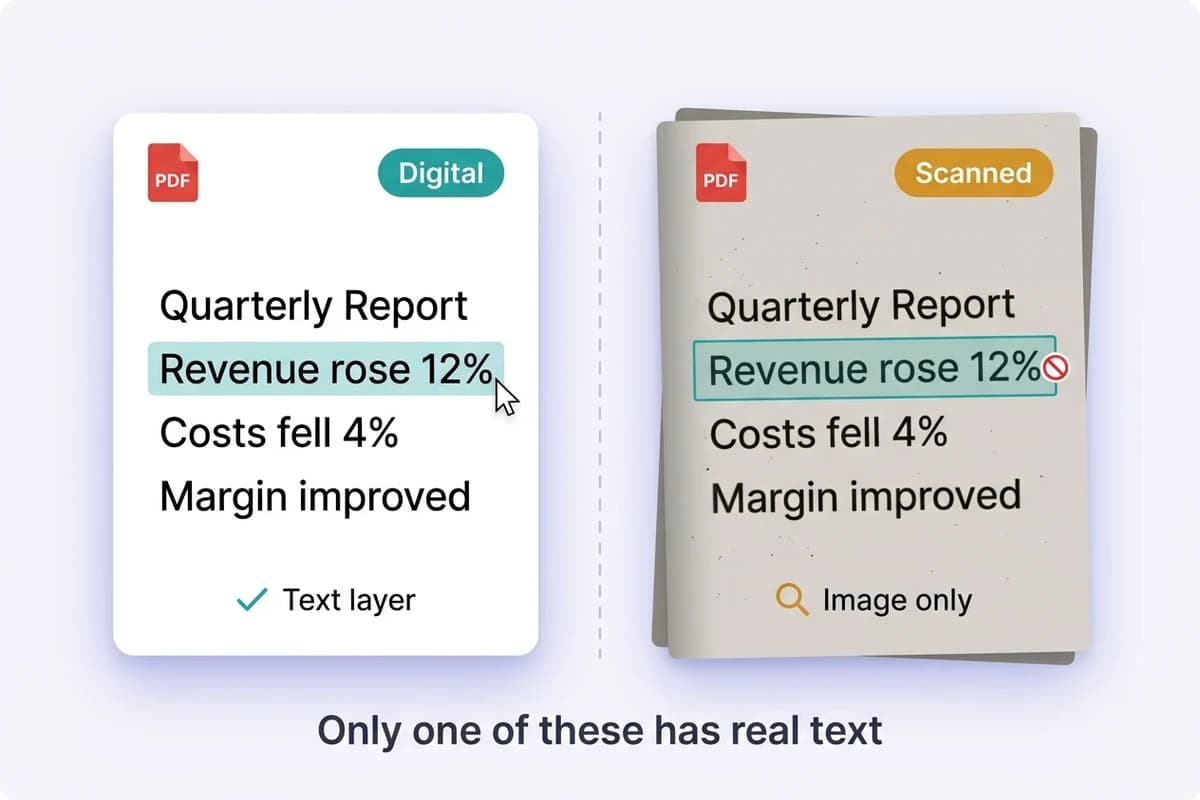
PDF digitale e PDF scansionato messi a confronto, con l'indicazione di quale richiede l'OCR

Che cosa esce bene

Documenti su una colonna

Relazioni, documentazione, articoli e contratti escono puliti: i titoli mantengono il livello e gli elenchi restano annidati.

Tabelle con i bordi

Le tabelle con le righe visibili vengono ricostruite come tabelle Markdown che si visualizzano correttamente ovunque.

Immagini incorporate

Le immagini dentro il PDF vengono estratte e richiamate nel testo, così non si perde nulla del documento.

Scansioni e moduli

Le pagine senza livello di testo vengono riconosciute con l'OCR, comprese le impaginazioni multilingue e i moduli compilati.

Come ottenere il risultato più pulito

  1. 1.

    Lascia decidere prima al riconoscimento

    Carica il file così com'è. Lo strumento verifica se c'è un livello di testo e propone l'OCR solo quando serve davvero: non paghi mai per un OCR che non era necessario.

  2. 2.

    Forza l'OCR se il risultato è illeggibile

    Le vecchie scansioni si portano dietro a volte un livello OCR scadente di anni fa. Inganna qualsiasi riconoscimento, per questo la pagina del risultato tiene un pulsante «esegui l'OCR» da usare quando il testo esce corrotto.

  3. 3.

    Rileggi le pagine su più colonne

    Colonne laterali, note a piè di pagina e articoli su due colonne vengono letti nell'ordine in cui il PDF li memorizza, che non è sempre l'ordine di lettura. Scorri quelle parti prima di fidarti.

  4. 4.

    Dividi i documenti molto lunghi

    I limiti di pagine esistono perché il tempo cresce con la lunghezza. Per libri o fascicoli conviene convertire capitolo per capitolo: anche la revisione ne guadagna.

Key Capabilities

Che cosa gestisce questo convertitore da PDF a Markdown

Pensato per i documenti su cui hai intenzione di continuare a lavorare, non solo da leggere.

OCR per i PDF scansionati

Le pagine senza livello di testo vengono riconosciute dalle immagini: scansioni, foto e moduli in oltre 170 lingue, cinese, giapponese e coreano compresi.

Struttura conservata

Livelli di titolo, elenchi annidati e citazioni tornano come Markdown vero, non come un impasto di paragrafi appiattiti.

Tabelle a barre verticali

Le tabelle con i bordi vengono ricostruite con le colonne allineate e si vedono correttamente in qualsiasi editor Markdown, wiki o repository.

Formule e immagini

Le immagini incorporate viaggiano con il documento e l'OCR recupera la notazione matematica dalle pagine tecniche scansionate.

Ritorno a Word

Manda il Markdown al convertitore Word con un clic e scarica un .docx: il documento modificabile che il PDF ti negava.

Eliminato dopo la conversione

Il file viaggia su una connessione cifrata, serve solo per questa conversione e poi viene eliminato. Non conserviamo né analizziamo nulla.

Use Cases

Chi converte i PDF in Markdown

Cinque lavori che questo strumento sbriga ogni giorno: uno somiglierà al tuo.

Sviluppatrici e sviluppatori

Tira fuori dal PDF riferimenti API, schede tecniche e manuali dei fornitori e portali nel sito di documentazione, nel README o nel wiki: Markdown che entra direttamente nel controllo di versione.

Ricerca

Trasforma gli articoli in note Markdown per Obsidian, Notion o Zotero. Le annate scansionate passano dall'OCR e le equazioni tornano in LaTeX invece che come caratteri rotti.

Redazione ed editing

Recupera testo pulito e modificabile da relazioni per i clienti, brief e cartelle stampa senza ribattere una pagina, poi continua nell'editor Markdown che usi già.

Studenti

Converti slide delle lezioni, dispense e appunti fotografati in Markdown che puoi cercare, riassumere e riorganizzare prima di un esame. Delle pagine fotografate si occupa l'OCR.

Pipeline IA e RAG

Il Markdown è ciò che i modelli linguistici leggono meglio. Converti i PDF di partenza prima di alimentare una base di conoscenza, un set di messa a punto o un prompt: struttura conservata, senza il rumore del PDF.

Simple Process

Come convertire un PDF in Markdown

Tre passaggi, e per iniziare non serve alcun account.

01

Carica il PDF

Trascina il file o cercalo sul computer. Dimensione e numero di pagine vengono verificati prima di elaborare qualsiasi cosa, così non aspetti mai per un file che verrà rifiutato.

02

Digitale o scansionato: lo riconosce lui

I documenti con livello di testo si convertono subito. Se il file si rivela una scansione, ti viene chiesto prima di avviare l'OCR: nessun addebito silenzioso.

03

Copia o scarica il Markdown

Rileggi il risultato, poi copialo negli appunti o scarica il file .md. Se una scansione esce corrotta, un pulsante la ripassa dall'OCR.

FAQ

Domande frequenti su PDF e Markdown

Limiti, OCR, qualità e riservatezza, spiegati senza giri di parole.

1

Questo convertitore da PDF a Markdown è gratis?

Sì. Ogni visitatore ha conversioni gratuite ogni giorno, e creare un account alza i limiti di dimensione e di pagine. L'OCR per i file scansionati consuma un credito a conversione, perché dietro c'è un motore di riconoscimento a pagamento.

2

Funziona con i PDF scansionati?

Sì, ed è proprio ciò che lo distingue dalla maggior parte dei convertitori gratuiti. Lo strumento verifica se il PDF ha un vero livello di testo; se non ce l'ha, propone l'OCR, che legge i caratteri dalle immagini delle pagine.

3

Quali sono i limiti di dimensione e di pagine?

Senza account puoi convertire PDF fino a 10 MB e 30 pagine. Con l'accesso si sale a 30 MB e 150 pagine e si sblocca l'OCR per i file scansionati, mentre gli abbonati arrivano a 50 MB e 300 pagine.

4

Quali lingue riconosce l'OCR?

Oltre 170, tra cui cinese, giapponese, coreano, arabo e le principali lingue europee. Le pagine con più lingue si risolvono in un solo passaggio: non devi scegliere la lingua prima.

5

Le tabelle vengono conservate?

Le tabelle con i bordi diventano in modo affidabile tabelle Markdown. Le tabelle senza righe e le celle molto unite sono il punto debole di qualsiasi analizzatore PDF: controlla quelle parti prima di fidarti.

6

Che fine fanno le immagini del PDF?

Le immagini incorporate vengono estratte e richiamate nel Markdown, quindi viaggiano con il documento. Nei PDF molto carichi di immagini possono essere scartate per mantenere il file gestibile, e in quel caso te lo diciamo.

7

Sono supportate le formule matematiche?

Nei documenti scansionati l'OCR restituisce le formule in notazione LaTeX. Nei PDF digitali la struttura delle equazioni è salvata come glifi posizionati anziché come marcatura, perciò le formule complesse arrivano come semplici caratteri: passare quelle pagine dall'OCR dà spesso un risultato migliore.

8

Perché il risultato sembra disordinato?

Impaginazioni su più colonne, colonne laterali e note a piè di pagina vengono lette nell'ordine in cui il PDF le memorizza, che non coincide sempre con l'ordine di lettura umano. I documenti su una colonna danno risultati molto più puliti. Se è il testo stesso a sembrare corrotto, il file si porta dietro probabilmente un livello OCR scadente: usa «esegui l'OCR» nella pagina del risultato.

9

Il mio PDF è al sicuro?

Sì. Il file viaggia su una connessione cifrata, viene usato solo per la conversione che hai chiesto e viene rimosso dall'archivio appena l'elaborazione finisce. Non leggiamo i tuoi documenti, non li usiamo mai per addestrare modelli e non li vendiamo né li pubblichiamo. La nostra informativa sulla privacy spiega nel dettaglio come vengono trattati i file caricati.

10

La conversione di un PDF consuma crediti?

Con l'accesso, ogni conversione consuma crediti: 1 credito ogni 30 pagine, con le pagine rimanenti arrotondate a un credito intero; la stessa regola vale per l'OCR dei file scansionati. Gli abbonati convertono senza limiti.

Trasforma quel PDF in qualcosa di modificabile

Scansionato o digitale: prima in Markdown, poi in Word, PDF o HTML.

Si parte subito · Conversioni gratuite ogni giorno · PDF scansionati gestiti con OCR