Guide complet : convertir un PDF en Markdown
Pourquoi certains PDF passent sans accroc et d'autres réclament de l'OCR – et comment obtenir le résultat le plus propre dans les deux cas.
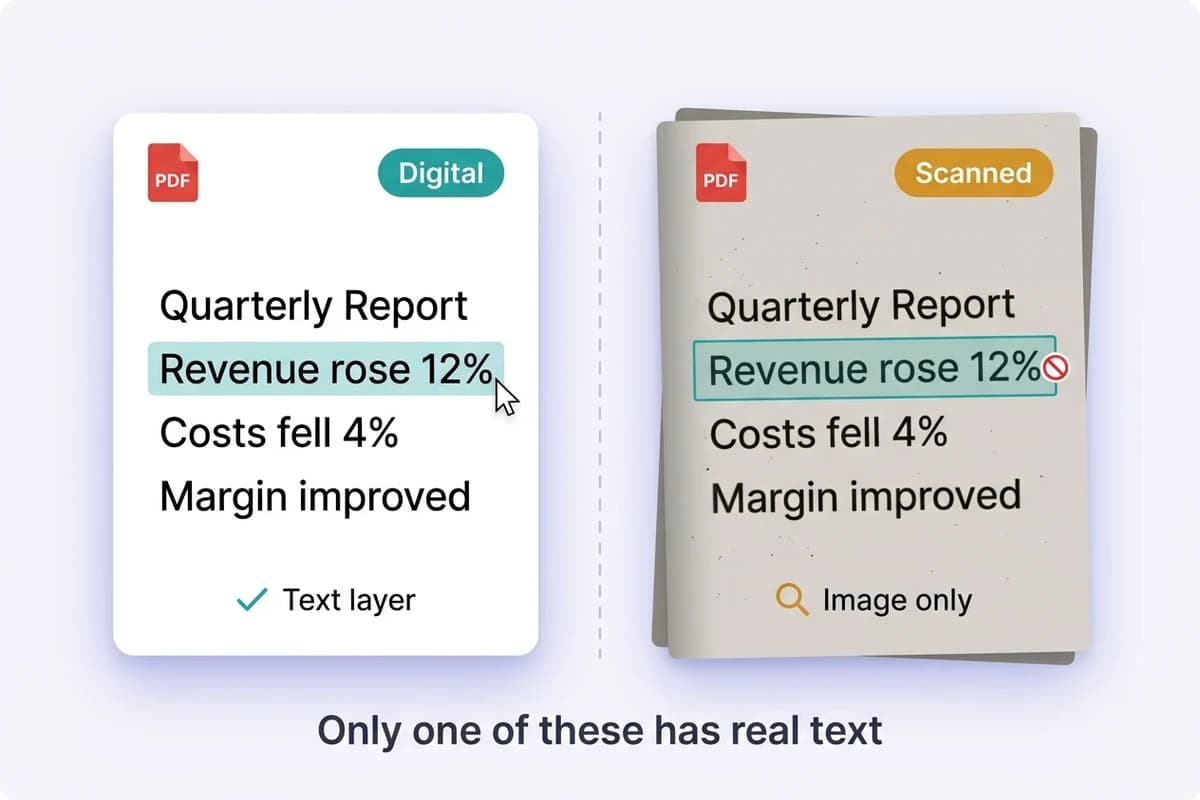
PDF numériques et PDF scannés
PDF numérique – avec couche texte
Produit par un logiciel (Word, LaTeX, la boîte d'impression du navigateur). Les caractères sont réellement dans le fichier, l'extraction est rapide et quasiment sans perte. C'est le cas d'environ 97 % des documents du quotidien, et cela prend quelques secondes.
PDF scanné – de simples images de pages
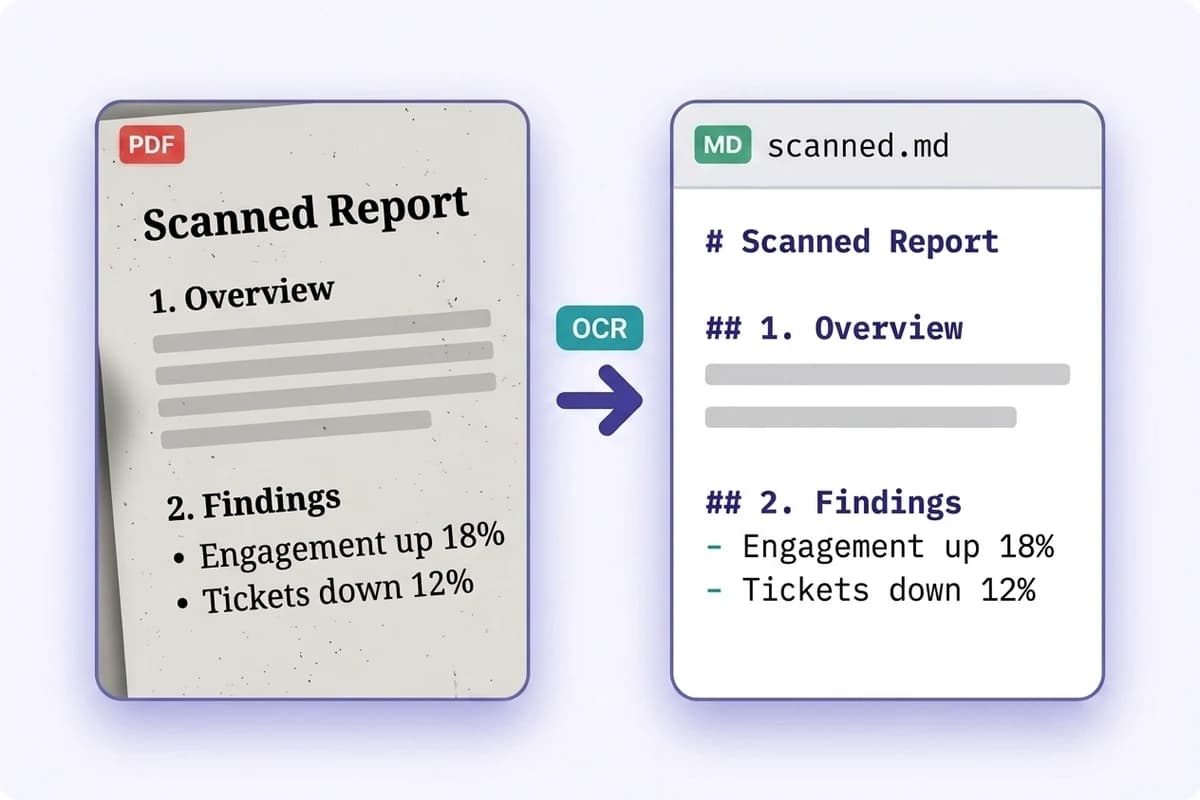
Sorti d'un photocopieur, d'un téléphone ou d'un fax. Il n'y a aucun texte à extraire : sélectionner et copier ne donne rien. Seul l'OCR sait les lire, et c'est précisément pour cela que la plupart des convertisseurs gratuits renvoient discrètement un fichier vide.
Ce qui passe bien
Documents sur une colonne
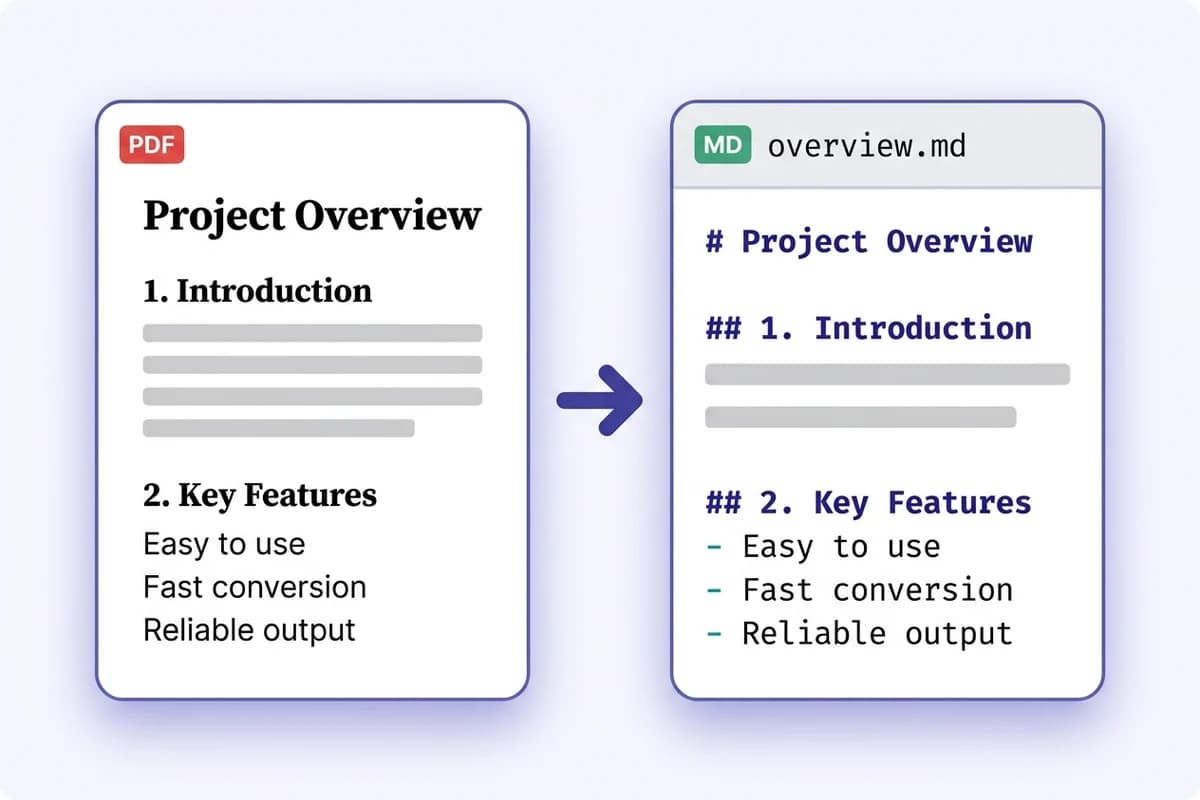
Rapports, documentations, articles et contrats passent proprement : les titres gardent leur niveau et les listes leur imbrication.
Tableaux à bordures
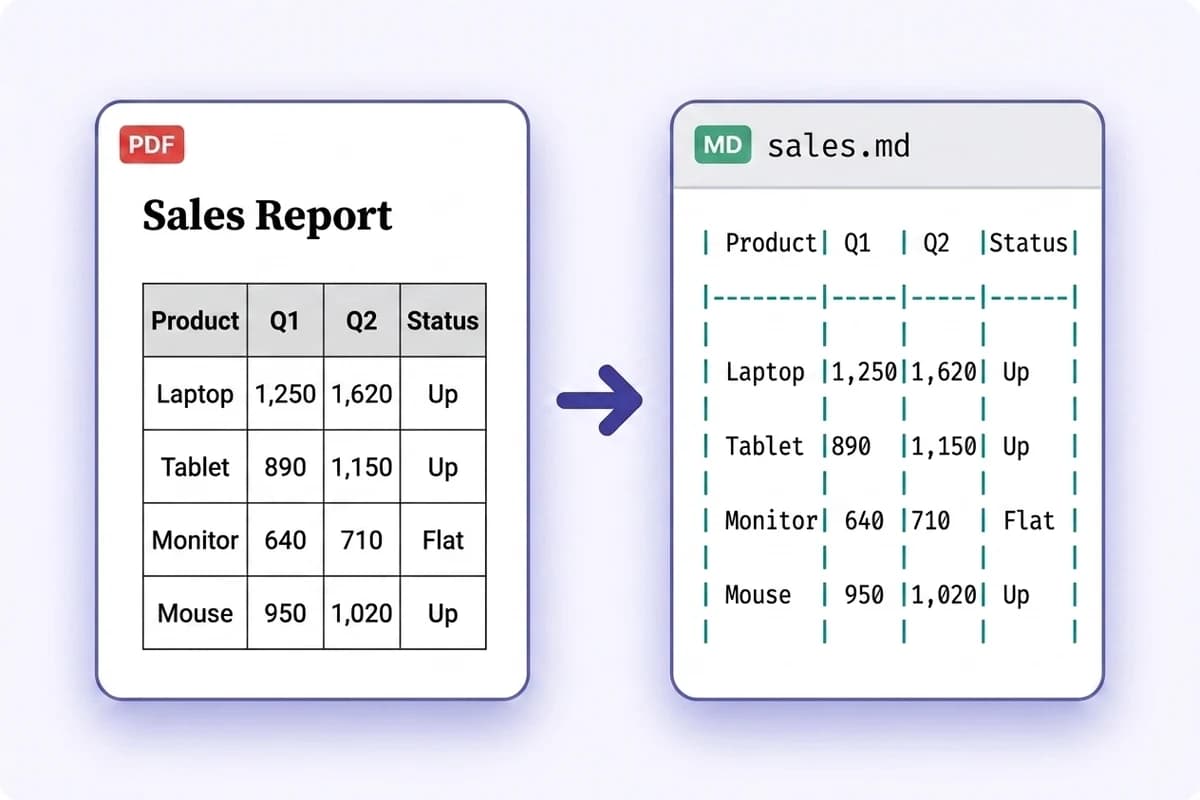
Les tableaux dont les filets sont visibles sont reconstruits en tableaux Markdown qui s'affichent correctement partout.
Images intégrées
Les images contenues dans le PDF sont extraites et référencées dans le texte, pour que rien ne disparaisse du document.
Scans et formulaires
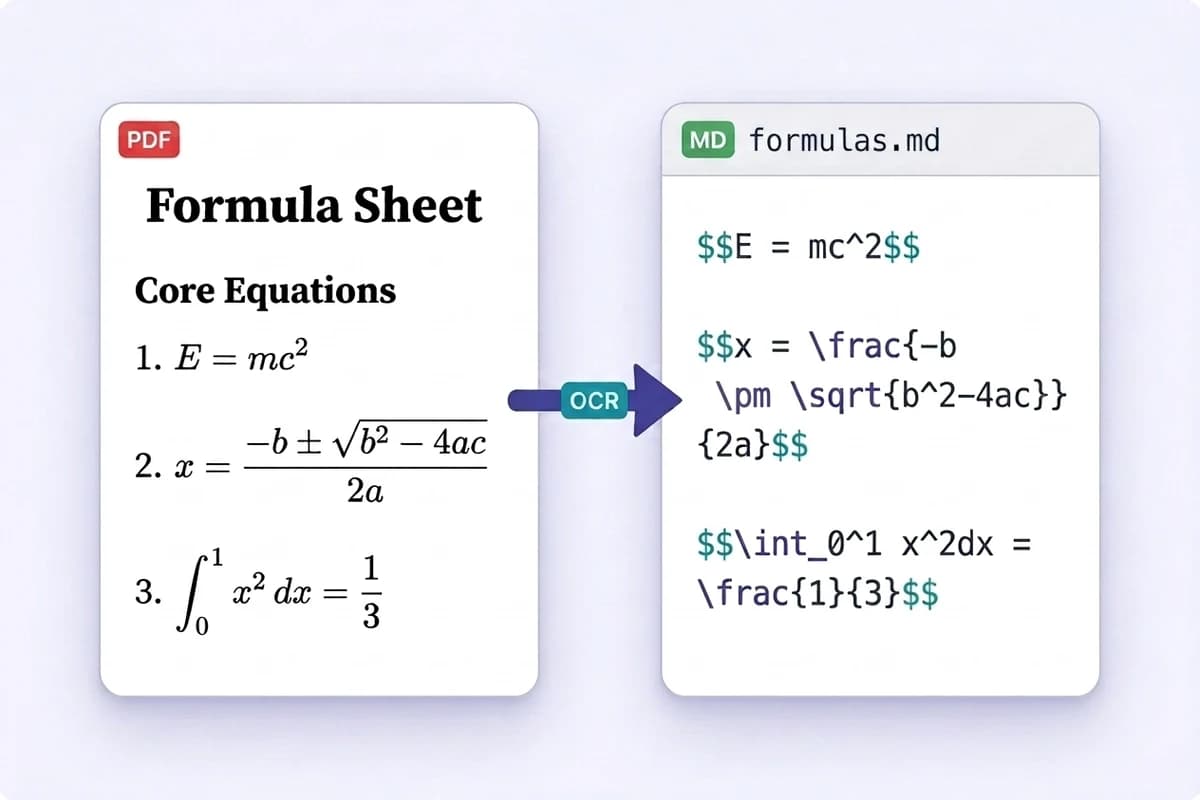
Les pages sans couche texte sont reconnues par OCR, y compris les mises en page multilingues et les formulaires remplis.
Obtenir le résultat le plus propre
- 1.
Laissez d'abord la détection trancher
Déposez le fichier tel quel. L'outil vérifie la présence d'une couche texte et ne propose l'OCR que si le fichier en a réellement besoin : vous ne payez jamais pour un OCR inutile.
- 2.
Forcez l'OCR si le résultat est illisible
Les vieux scans traînent parfois une mauvaise couche OCR datant d'années passées. Aucune détection n'y résiste, c'est pourquoi la page de résultat garde un bouton « lancer l'OCR à la place » – à utiliser dès que le texte ressort déformé.
- 3.
Relisez les pages multicolonnes
Encadrés, notes de bas de page et articles sur deux colonnes sont lus dans l'ordre où le PDF les stocke, qui n'est pas toujours l'ordre de lecture. Parcourez ces passages avant de vous y fier.
- 4.
Découpez les documents très longs
Les limites de pages existent parce que la durée croît avec la longueur. Pour un livre ou un dossier, convertissez chapitre par chapitre – la relecture y gagne aussi.