Gratis – OCR incluido

Convertir PDF a Markdown gratis, también escaneados

Ante un PDF escaneado, la mayoría de convertidores se rinden. Este lo detecta y ejecuta OCR: informes, contratos y formularios salen como Markdown de verdad, con tablas, títulos y fórmulas.

Suelta aquí un PDF o haz clic para buscarlo

Hasta 10 MB y 30 páginas · inicia sesión para ampliar el límite

¿Qué es convertir un PDF a Markdown?

Convertir un PDF a Markdown consiste en sacar el texto y la estructura encerrados en el PDF y reescribirlos como texto plano: los títulos pasan a ser líneas con almohadilla, las tablas se vuelven tablas con barras verticales y las imágenes viajan con el documento. La parte difícil: buena parte de los PDF son escaneados sin capa de texto, donde la extracción no devuelve nada y solo el OCR sirve. Esta herramienta detecta de cuál se trata. Con el Markdown en la mano puedes seguir hacia Word (.docx), PDF o HTML.

Tres maneras de pasar de PDF a Markdown

1

Convertidores en línea: subes un PDF y en segundos tienes el Markdown. La mejor opción si quieres conservar la estructura sin instalar nada, y la única vía práctica para escaneados que necesitan OCR.

2

Línea de comandos: bibliotecas como pymupdf4llm o marker trabajan en local y se pueden automatizar por lotes. Buena opción para desarrolladores con muchos archivos, a cambio de instalación, ajustes y sin OCR de serie.

3

Copiar y pegar: seleccionar el texto en un lector de PDF y pegarlo en un editor. Vale para un párrafo, pero títulos, tablas y diseños a varias columnas se desmoronan, y de las páginas escaneadas no sale nada.

Example Output

Cómo queda el resultado de verdad

Cuatro cosas que este convertidor hace bien y que un copiar y pegar nunca conseguirá.

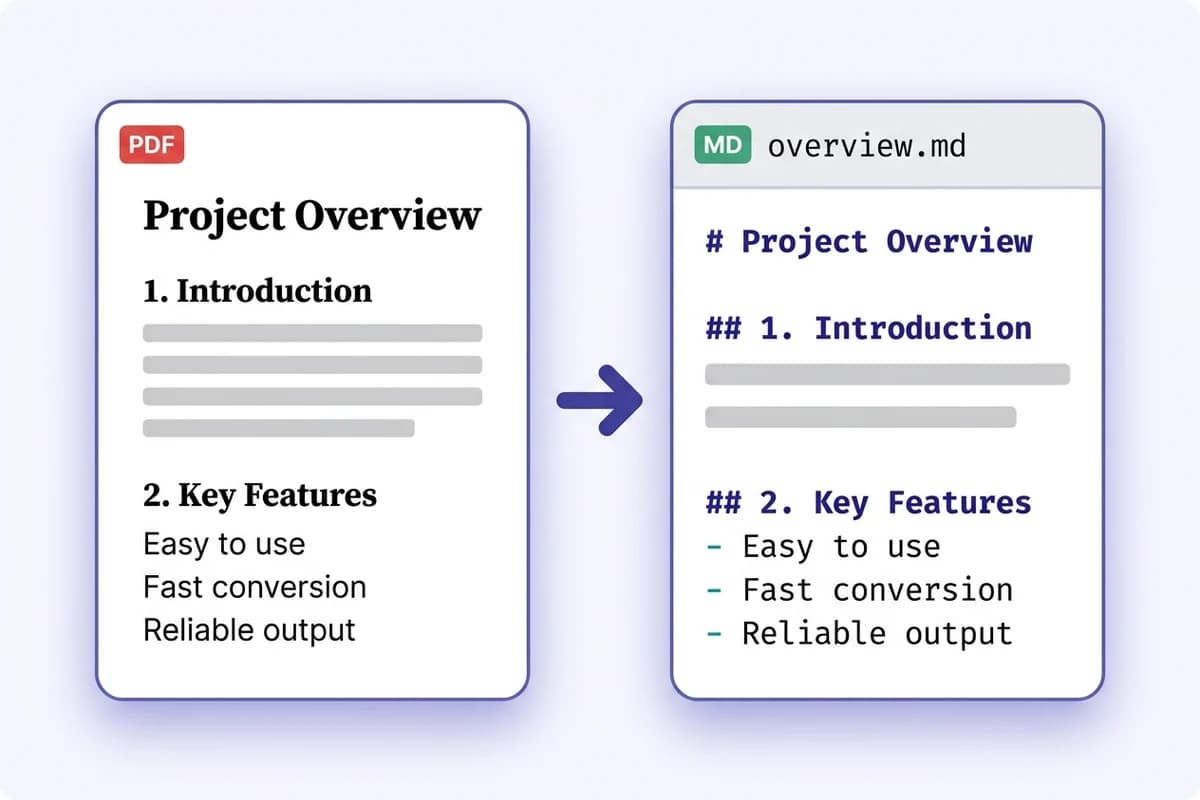
Los títulos y la estructura aguantan

Los niveles de título, las listas anidadas y los saltos de párrafo se reconstruyen como Markdown real, así el documento queda listo para editar o publicar en vez de ser un muro de texto.

Un resumen de proyecto en PDF convertido en Markdown estructurado, con los niveles de título y las listas anidadas conservados

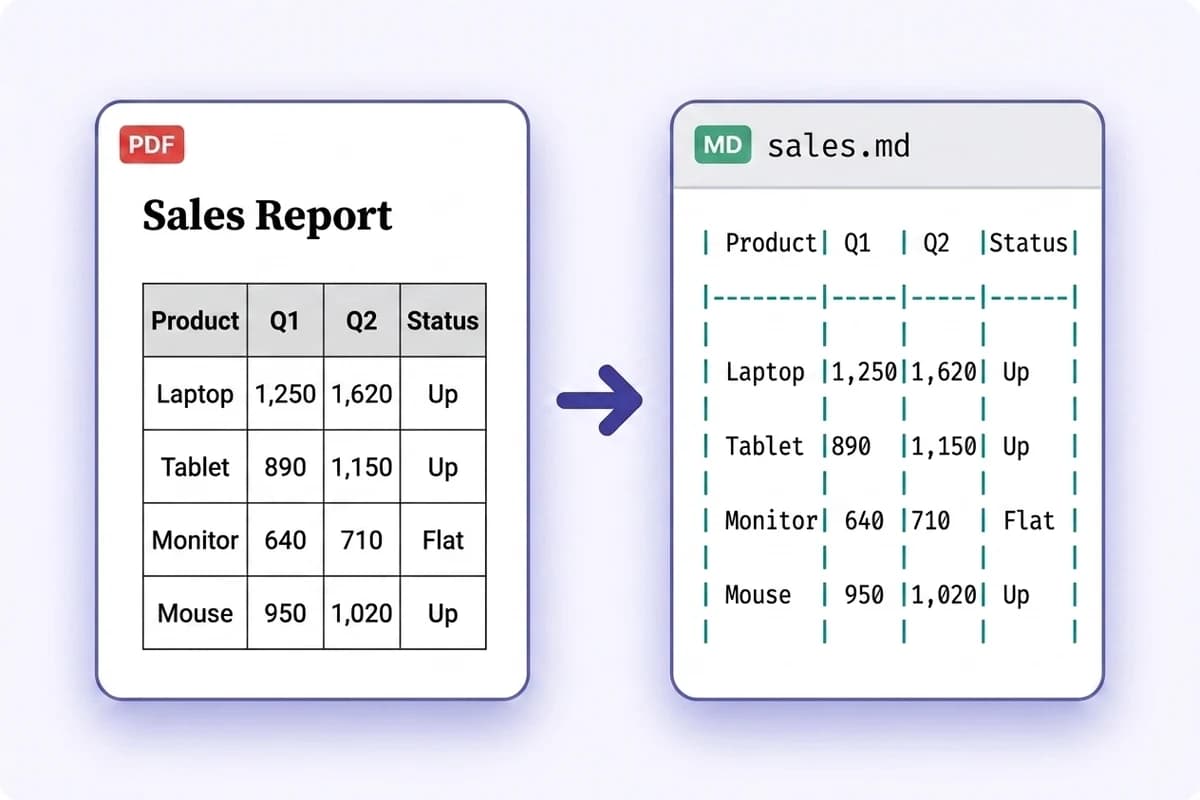
Las tablas pasan a ser tablas de Markdown

Las tablas con bordes se reconstruyen con barras verticales y columnas alineadas: informes, especificaciones y comparativas siguen siendo reutilizables en lugar de deshacerse en texto suelto.

Una tabla de ventas de un PDF convertida en una tabla de Markdown con columnas alineadas

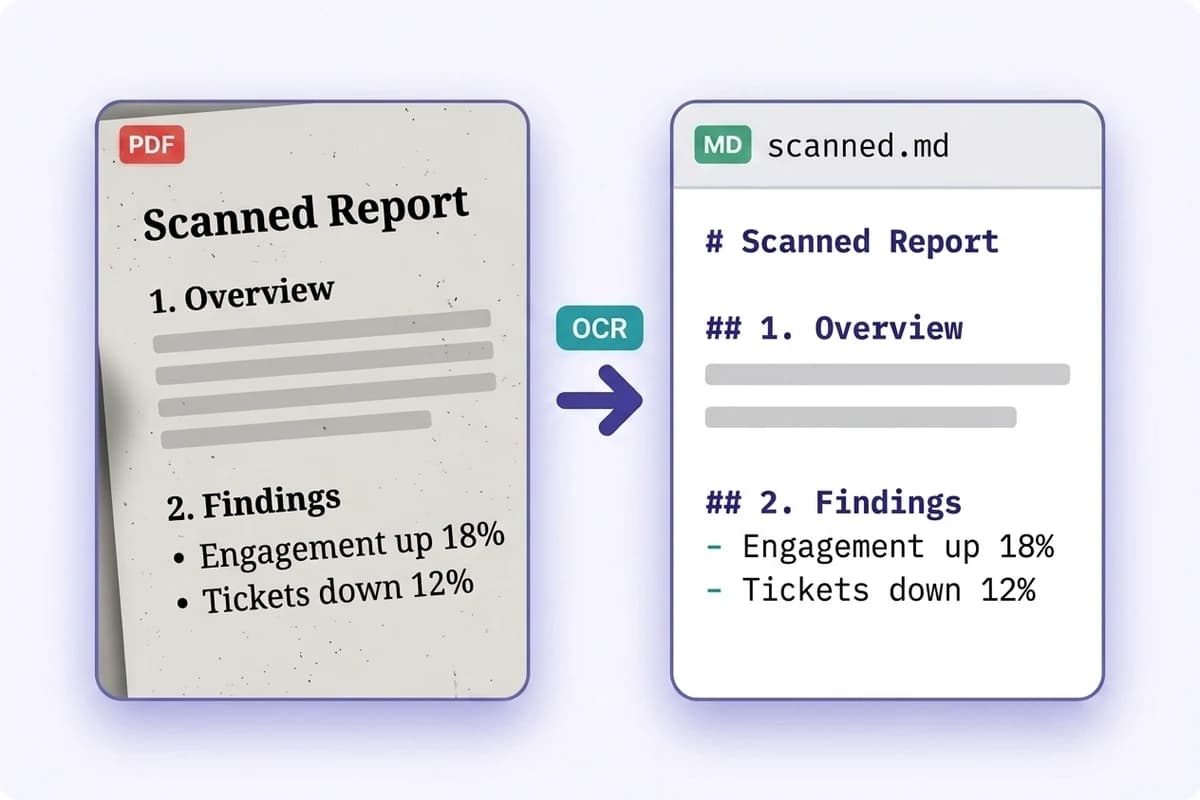
Páginas escaneadas leídas con OCR

Cuando un PDF no tiene capa de texto, el OCR lee las imágenes de página: escaneados, documentos fotografiados y formularios en más de 170 idiomas, chino, japonés y coreano incluidos.

Un informe en papel escaneado, reconocido por OCR y convertido en Markdown editable

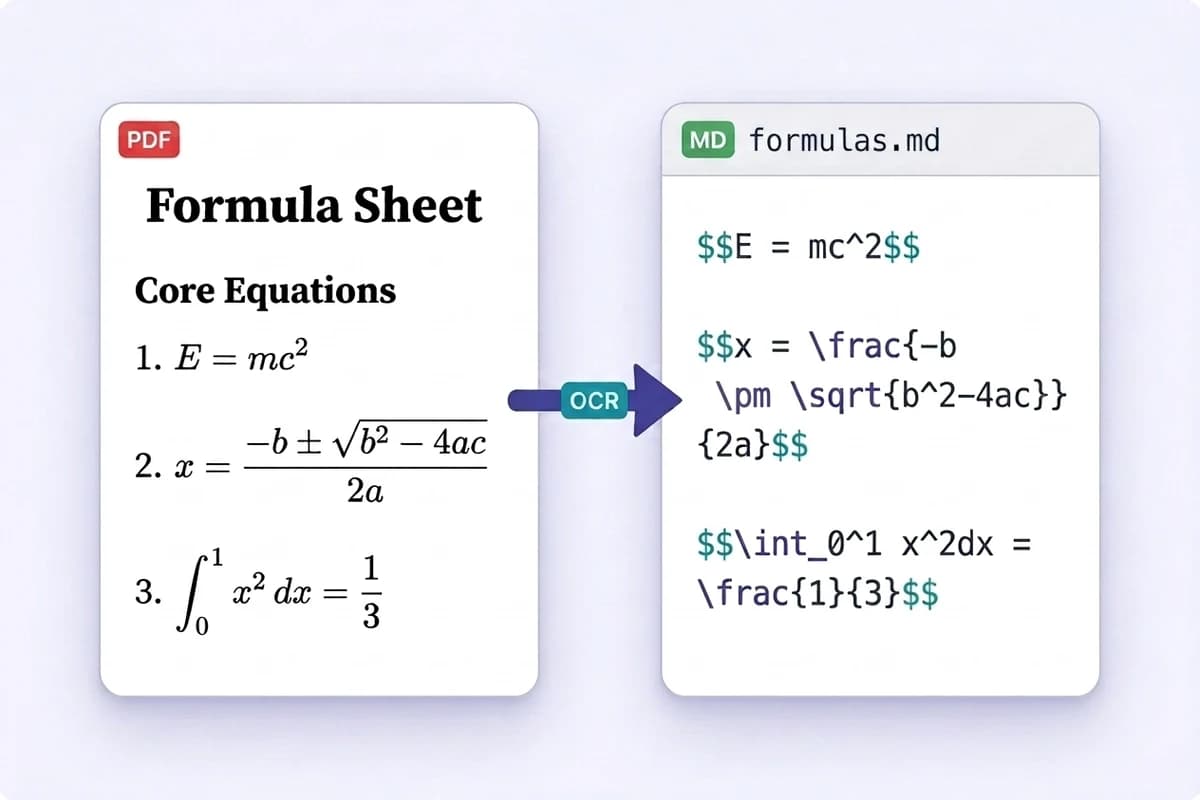
Las fórmulas vuelven como LaTeX

Pasa una hoja de fórmulas por OCR y las matemáticas regresan como LaTeX de verdad dentro de bloques $$: fracciones, raíces, integrales y superíndices conservan su estructura, listos para Obsidian, Notion o un artículo. (En los PDF digitales las ecuaciones se guardan como glifos sueltos, por eso el OCR es la vía que las recupera bien.)

Una hoja de fórmulas en PDF convertida por OCR en Markdown con ecuaciones LaTeX entre bloques de signos de dólar

Guía completa: convertir un PDF a Markdown

Por qué unos PDF salen impecables y otros necesitan OCR, y cómo obtener el resultado más limpio en ambos casos.

PDF digitales frente a PDF escaneados

PDF digital: tiene capa de texto

Lo generó un programa (Word, LaTeX, el cuadro de impresión del navegador). Los caracteres están realmente en el archivo, así que la extracción es rápida y casi sin pérdidas. Es el caso de alrededor del 97 % de los documentos del día a día, y tarda segundos.

PDF escaneado: solo fotos de páginas

Salió de una fotocopiadora, la cámara del móvil o un fax. No hay texto que extraer: seleccionar y copiar no devuelve nada. Solo el OCR sabe leerlos, y justo por eso la mayoría de convertidores gratuitos entregan en silencio un archivo vacío.
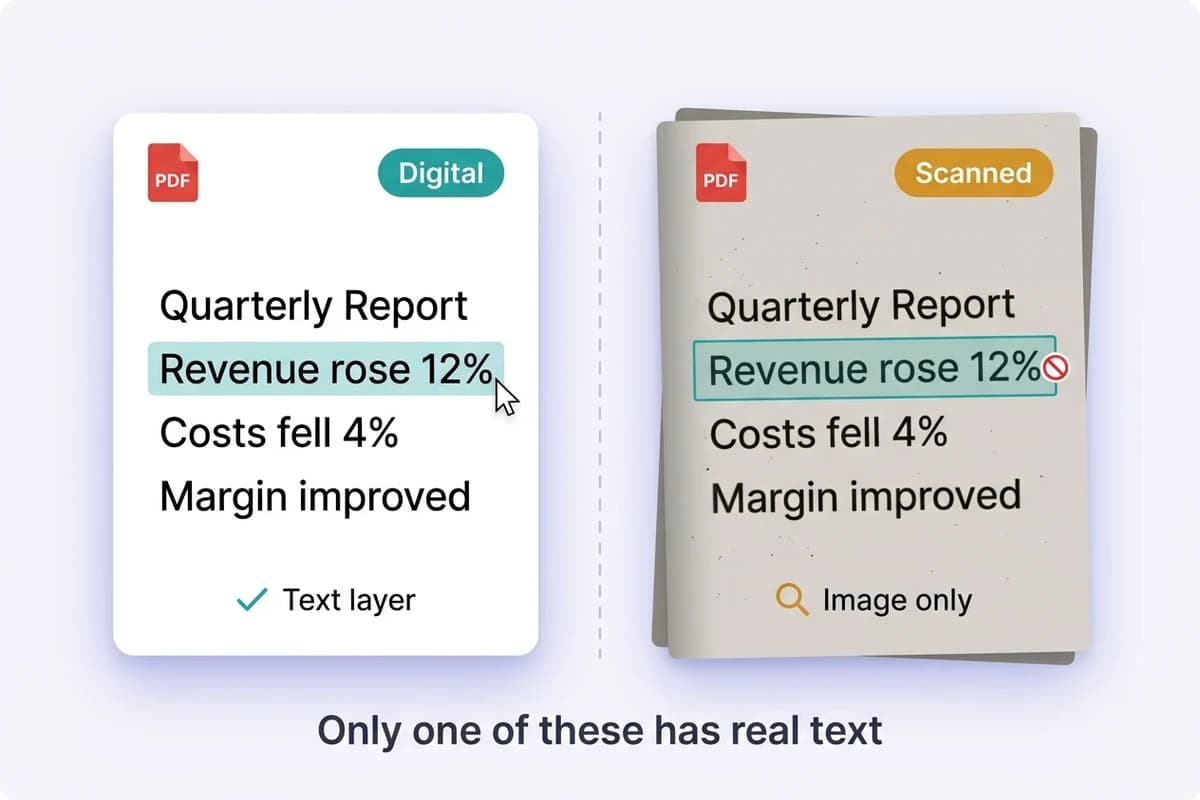
PDF digital y PDF escaneado comparados uno al lado del otro, señalando cuál necesita OCR

Qué sale bien

Documentos a una columna

Informes, documentación, artículos y contratos salen limpios: los títulos mantienen su nivel y las listas su anidamiento.

Tablas con bordes

Las tablas con líneas visibles se reconstruyen como tablas de Markdown que se ven correctamente en cualquier sitio.

Imágenes incrustadas

Las imágenes dentro del PDF se extraen y se referencian en el texto, para que no se pierda nada del documento.

Escaneados y formularios

Las páginas sin capa de texto se reconocen con OCR, incluidos los diseños multilingües y los formularios rellenados.

Cómo conseguir el resultado más limpio

  1. 1.

    Deja que decida primero la detección

    Sube el archivo tal cual. La herramienta comprueba si hay capa de texto y solo ofrece OCR cuando el archivo lo necesita de verdad, así nunca pagas por un OCR que no hacía falta.

  2. 2.

    Fuerza el OCR si sale ilegible

    Los escaneados antiguos arrastran a veces una capa de OCR mala de hace años. Eso engaña a cualquier detección, por eso la página de resultado mantiene un botón de «ejecutar OCR en su lugar»: úsalo cuando el texto salga corrompido.

  3. 3.

    Revisa las páginas a varias columnas

    Barras laterales, notas al pie y artículos a dos columnas se leen en el orden en que el PDF los guarda, que no siempre coincide con el orden de lectura. Repasa esas partes antes de darlas por buenas.

  4. 4.

    Divide los documentos muy largos

    Los límites de páginas existen porque el tiempo crece con la extensión. Para libros o expedientes, convierte por capítulos: además el resultado se revisa mucho mejor.

Key Capabilities

Qué resuelve este convertidor de PDF a Markdown

Pensado para documentos con los que vas a seguir trabajando, no solo leerlos.

OCR para PDF escaneados

Las páginas sin capa de texto se reconocen desde las imágenes: escaneados, fotos y formularios en más de 170 idiomas, chino, japonés y coreano incluidos.

Estructura conservada

Niveles de título, listas anidadas y citas vuelven como Markdown real, no como una masa de párrafos aplanados.

Tablas con barras verticales

Las tablas con bordes se reconstruyen con columnas alineadas y se ven bien en cualquier editor de Markdown, wiki o repositorio.

Fórmulas e imágenes

Las imágenes incrustadas viajan con el documento, y el OCR recupera la notación matemática de las páginas técnicas escaneadas.

Vuelta a Word

Manda el Markdown al convertidor de Word con un clic y descarga un .docx: el documento editable que el PDF te negaba.

Se borra tras la conversión

Tu archivo viaja por una conexión cifrada, se usa solo para esta conversión y después se elimina. No se guarda ni se analiza nada.

Use Cases

Quién convierte PDF a Markdown

Cinco tareas que esta herramienta resuelve a diario; alguna se parecerá a la tuya.

Desarrolladores

Saca del PDF referencias de API, fichas técnicas y manuales de proveedor y llévalas a tu sitio de documentación, tu README o tu wiki: Markdown que entra directo en el control de versiones.

Investigación

Convierte artículos en notas de Markdown para Obsidian, Notion o Zotero. Los números atrasados escaneados pasan por OCR y las ecuaciones vuelven como LaTeX en lugar de caracteres rotos.

Redacción y edición

Consigue texto limpio y editable de informes de cliente, briefings y dosieres de prensa sin teclear una página, y sigue trabajando en el editor de Markdown que ya usas.

Estudiantes

Convierte diapositivas de clase, apuntes y notas fotografiadas en Markdown que puedes buscar, resumir y reordenar antes de un examen. De las páginas fotografiadas se encarga el OCR.

Flujos de IA y RAG

El Markdown es lo que mejor leen los modelos de lenguaje. Convierte los PDF de origen antes de alimentar una base de conocimiento, un conjunto de ajuste fino o un prompt: estructura conservada, sin el ruido del PDF.

Simple Process

Cómo convertir un PDF a Markdown

Tres pasos, y no hace falta cuenta para empezar.

01

Sube tu PDF

Arrastra el archivo o búscalo en tu equipo. El tamaño y el número de páginas se comprueban antes de procesar nada, así nunca esperas por un archivo que va a ser rechazado.

02

Digital o escaneado: lo detecta por ti

Los documentos con capa de texto se convierten al momento. Si el archivo resulta ser un escaneado, se te pregunta antes de ejecutar el OCR: nunca se cobra en silencio.

03

Copia o descarga tu Markdown

Revisa el resultado y cópialo al portapapeles o descarga el archivo .md. Si un escaneado sale corrompido, un botón lo vuelve a pasar por OCR.

FAQ

Preguntas frecuentes sobre PDF a Markdown

Límites, OCR, calidad y privacidad, explicados sin rodeos.

1

¿Este convertidor de PDF a Markdown es gratis?

Sí. Cada visitante tiene conversiones gratuitas cada día, y crear una cuenta sube los límites de tamaño y de páginas. El OCR de archivos escaneados consume un crédito por conversión, porque detrás hay un motor de reconocimiento de pago.

2

¿Funciona con PDF escaneados?

Sí, y es justo lo que lo separa de la mayoría de convertidores gratuitos. La herramienta comprueba si tu PDF tiene una capa de texto real; si no la tiene, ofrece OCR, que lee los caracteres desde las imágenes de página.

3

¿Qué límites hay de tamaño y de páginas?

Sin cuenta puedes convertir PDF de hasta 10 MB y 30 páginas. Al iniciar sesión sube a 30 MB y 150 páginas y se activa el OCR para archivos escaneados, mientras que los suscriptores llegan a 50 MB y 300 páginas.

4

¿Qué idiomas reconoce el OCR?

Más de 170, entre ellos chino, japonés, coreano, árabe y las principales lenguas europeas. Las páginas con varios idiomas se resuelven en una sola pasada: no tienes que elegir idioma antes.

5

¿Se conservan las tablas?

Las tablas con bordes se convierten de forma fiable en tablas de Markdown. Las tablas sin líneas y las celdas muy combinadas son el punto débil de cualquier analizador de PDF, así que revisa esas partes antes de fiarte.

6

¿Qué pasa con las imágenes del PDF?

Las imágenes incrustadas se extraen y se referencian en el Markdown, así que viajan con el documento. En PDF muy cargados de imágenes puede que se descarten para que el archivo siga siendo manejable, y se te avisa cuando ocurre.

7

¿Admite fórmulas matemáticas?

En documentos escaneados, el OCR recupera las fórmulas en notación LaTeX. En los PDF digitales la estructura de las ecuaciones se guarda como glifos colocados y no como marcado, así que las fórmulas complejas llegan como caracteres sueltos: pasar esas páginas por OCR suele dar mejor resultado.

8

¿Por qué mi resultado sale desordenado?

Los diseños a varias columnas, las barras laterales y las notas al pie se leen en el orden en que el PDF los guarda, que no siempre coincide con el orden en que lee una persona. Los documentos a una columna dan resultados mucho más limpios. Si el texto en sí sale corrompido, es probable que el archivo arrastre una capa de OCR mala: usa «ejecutar OCR en su lugar» en la página de resultado.

9

¿Está seguro mi PDF?

Sí. Tu archivo viaja por una conexión cifrada, se usa solo para la conversión que has pedido y se retira del almacenamiento en cuanto termina el procesamiento. No leemos tus documentos, nunca los usamos para entrenar modelos y no los vendemos ni los publicamos. Nuestra política de privacidad detalla exactamente cómo se tratan los archivos subidos.

10

¿Convertir un PDF consume créditos?

Con la sesión iniciada, cada conversión consume créditos: 1 crédito por cada 30 páginas, y las páginas sobrantes se redondean a un crédito completo; la misma regla se aplica al OCR de archivos escaneados. Los suscriptores convierten sin límites.

Convierte ese PDF en algo que puedas editar

Escaneado o digital: primero a Markdown y después a Word, PDF o HTML.

Empieza al instante · Conversiones gratuitas cada día · PDF escaneados con OCR