دليل كامل: تحويل PDF إلى Markdown
لماذا تمرّ بعض ملفات PDF بسلاسة بينما تحتاج أخرى إلى OCR — وكيف تحصل على أنظف نتيجة في الحالتين.
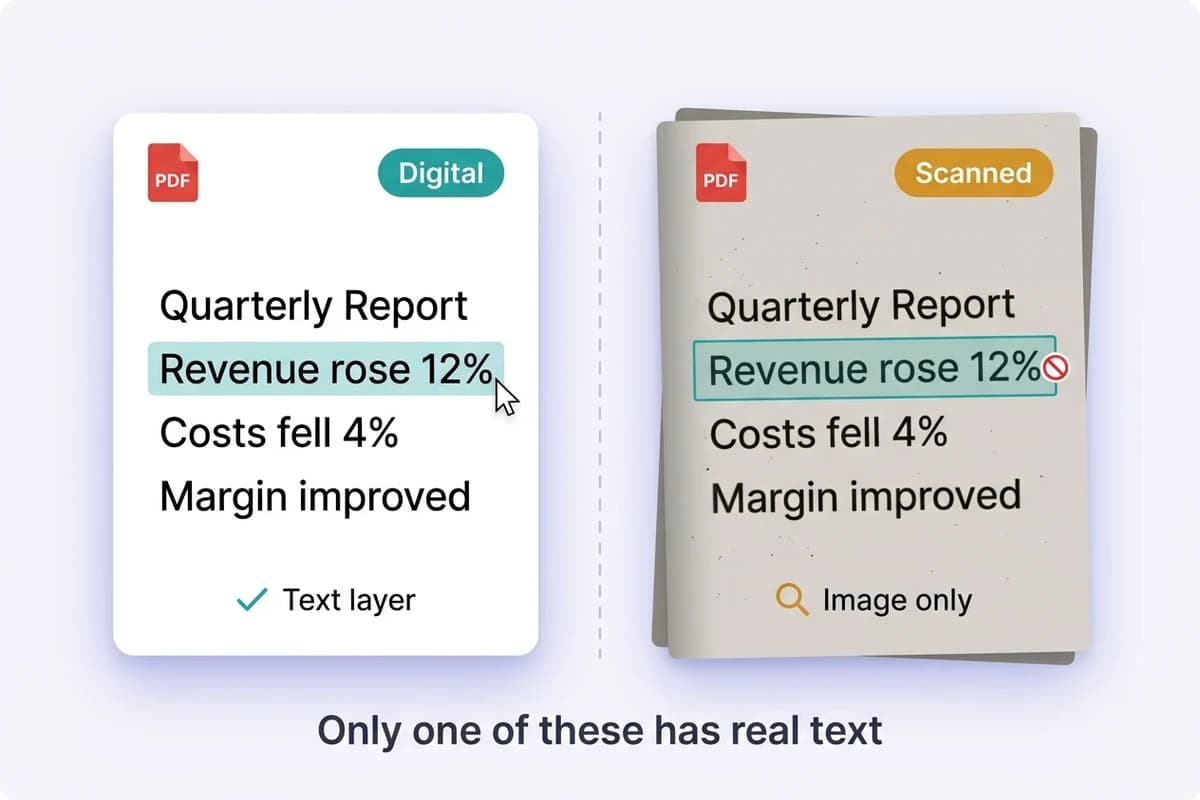
ملفات PDF الرقمية والممسوحة ضوئيًا
PDF رقمي — فيه طبقة نص
أنشأه برنامج (Word أو LaTeX أو نافذة الطباعة في المتصفح). الحروف موجودة فعلًا داخل الملف، فيكون الاستخراج سريعًا وبلا فقد يُذكر. ينطبق ذلك على نحو 97 % من مستندات كل يوم، ولا يستغرق سوى ثوانٍ.
PDF ممسوح ضوئيًا — مجرد صور للصفحات
خرج من آلة نسخ أو كاميرا هاتف أو فاكس. لا يوجد نص لاستخراجه، والتحديد والنسخ لا يعطيان شيئًا. لا يقرأها سوى OCR، ولهذا السبب بالذات تعيد أغلب الأدوات المجانية ملفًا فارغًا دون أن تنبّهك.
ما الذي يخرج جيدًا
المستندات بعمود واحد
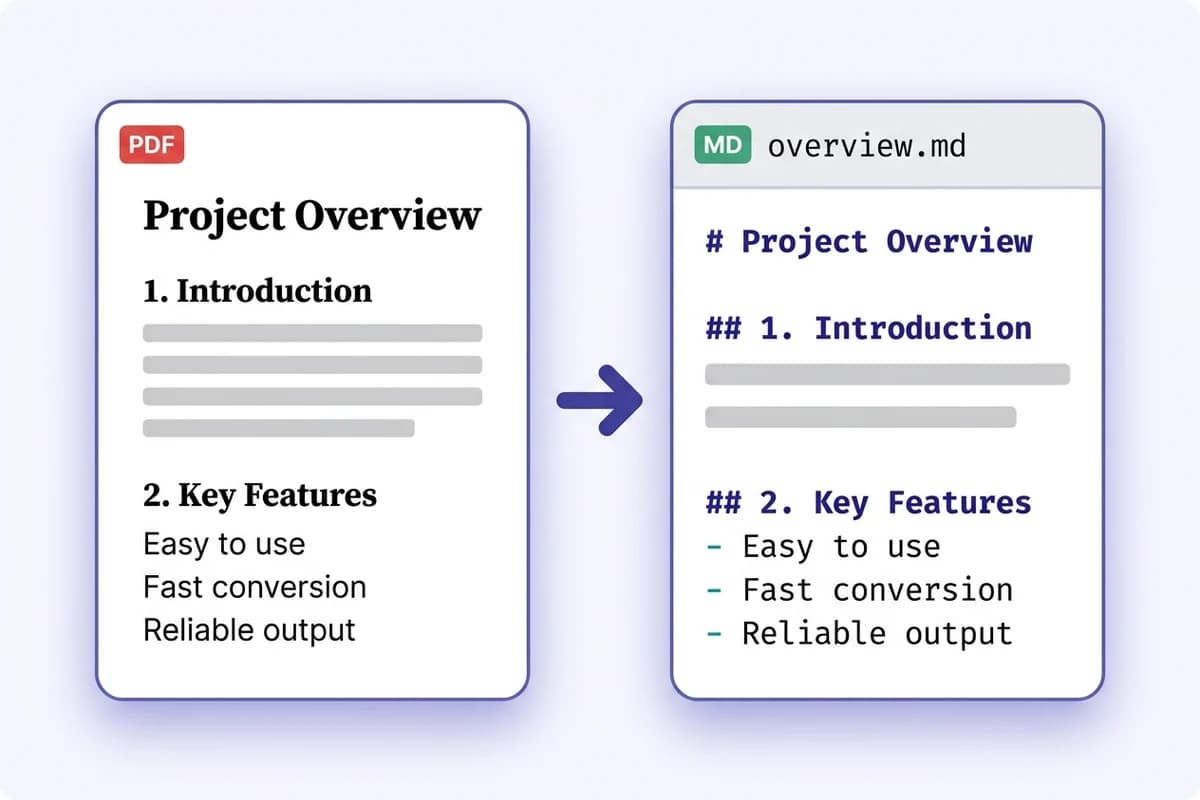
التقارير والتوثيق والأبحاث والعقود تمرّ نظيفة: العناوين تحتفظ بمستواها والقوائم تبقى متداخلة.
الجداول ذات الإطارات
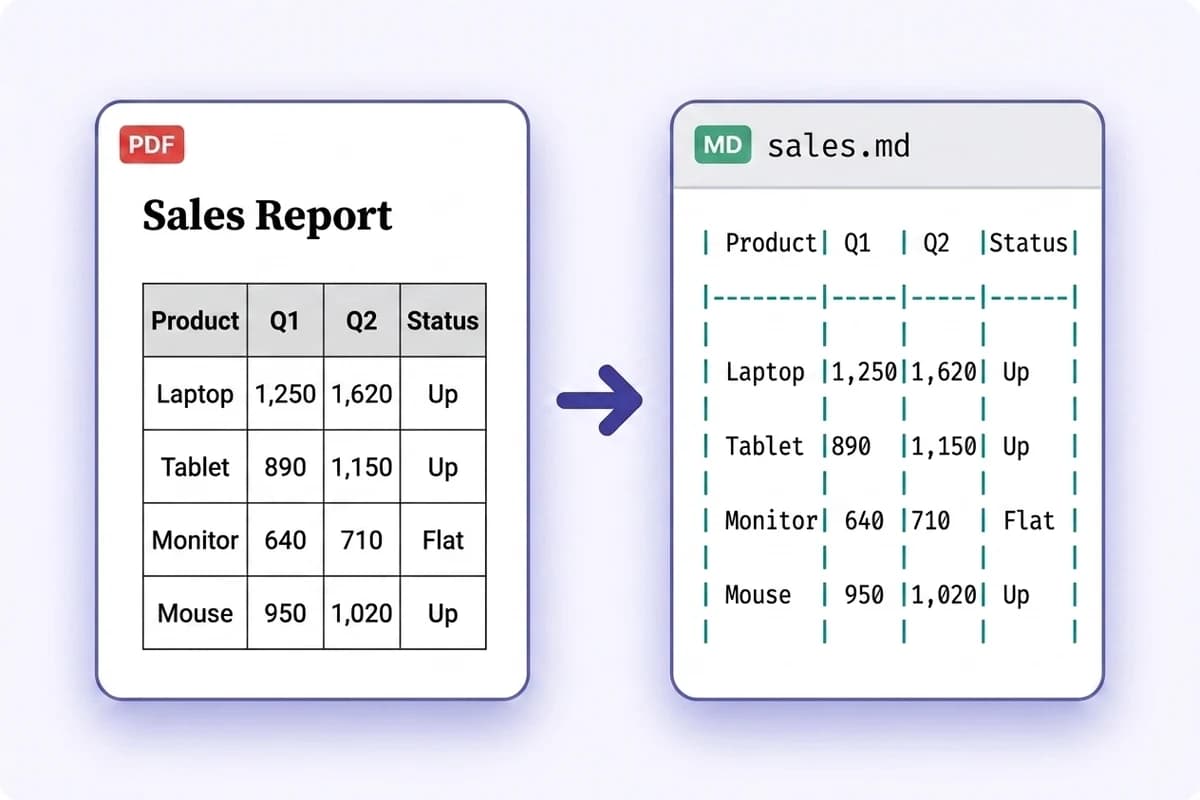
الجداول التي تظهر خطوطها يُعاد بناؤها كجداول Markdown تُعرض بشكل صحيح في أي مكان.
الصور المضمّنة
الصور داخل الملف تُستخرج ويُشار إليها في النص، حتى لا يضيع شيء من المستند.
النسخ الممسوحة والنماذج
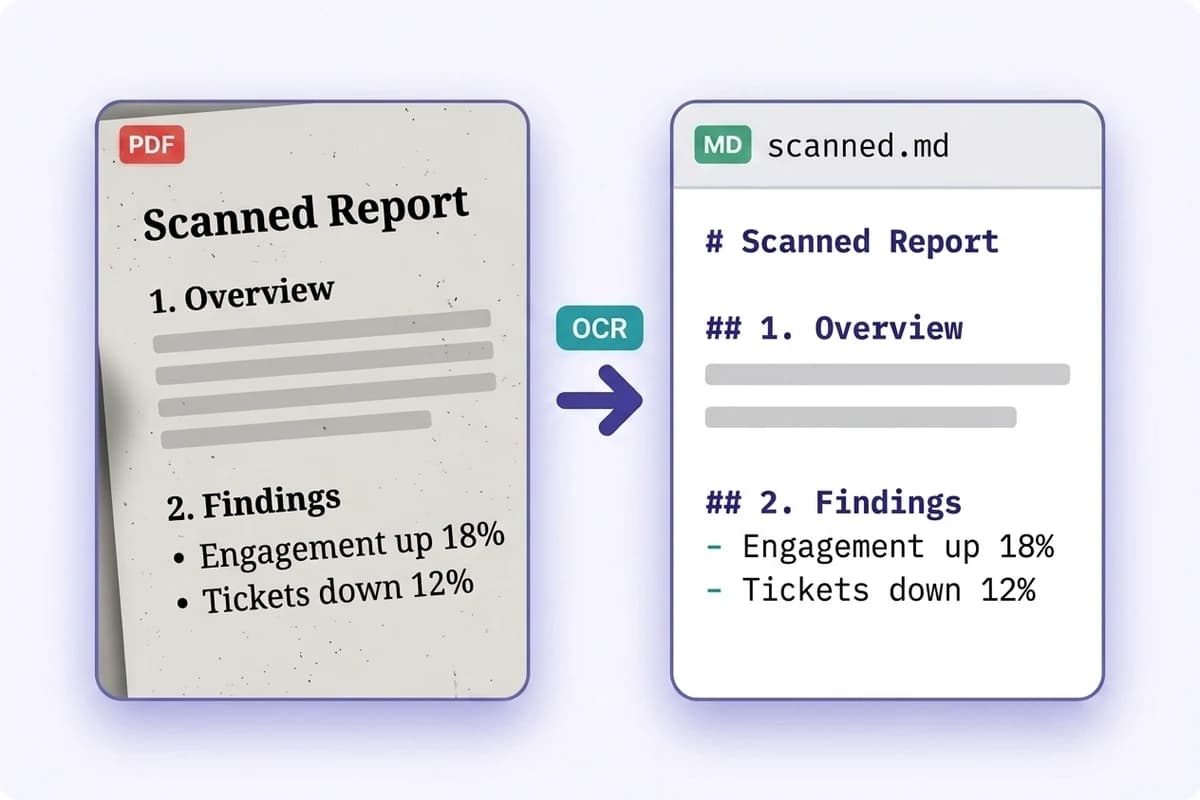
الصفحات بلا طبقة نص يتعرّف عليها OCR، بما في ذلك التنسيقات متعددة اللغات والنماذج المعبّأة.
كيف تحصل على أنظف نتيجة
- 1.
دع الكشف التلقائي يقرّر أولًا
ارفع الملف كما هو. تتحقق الأداة من وجود طبقة نص ولا تعرض OCR إلا حين يحتاجه الملف فعلًا، فلا تدفع أبدًا مقابل OCR لم تكن بحاجة إليه.
- 2.
شغّل OCR يدويًا إذا خرج النص مشوّشًا
النسخ الممسوحة القديمة تحمل أحيانًا طبقة OCR رديئة من سنوات مضت، وهي تخدع أي كشف تلقائي. لذلك تُبقي صفحة النتيجة زر «شغّل OCR بدلًا من ذلك» — استخدمه حين يصلك النص مشوّهًا.
- 3.
راجع الصفحات متعددة الأعمدة
الأعمدة الجانبية والحواشي والأبحاث ذات العمودين تُقرأ بالترتيب الذي يخزّنه الملف، وهو لا يطابق دائمًا ترتيب القراءة. تصفّح تلك المواضع قبل الاعتماد عليها.
- 4.
قسّم المستندات الطويلة جدًا
حدود الصفحات موجودة لأن الوقت يزداد مع الطول. الكتب والملفات الكبيرة يفضَّل تحويلها فصلًا فصلًا — وستكون مراجعة النتيجة أسهل بكثير.